

Hoy en día, las bases de datos son el motor silencioso que impulsa casi todas las facetas de nuestra vida digital, desde las transacciones bancarias hasta las redes sociales y la gestión empresarial. Pero, ¿cómo llegamos a tener sistemas tan sofisticados? La historia de las bases de datos es un viaje fascinante de evolución y adaptación para manejar volúmenes de información cada vez mayores y más complejos.
https://www.youtube.com/watch?v=ygUMI2Jhc2VzZGVkYXRv
Una Base de Datos es, en esencia, una colección organizada de datos diseñados para un propósito específico. Su organización permite un acceso, gestión y actualización eficientes. Si bien esta definición podría aplicarse a colecciones físicas como bibliotecas o archivadores, en el contexto informático se refiere casi exclusivamente a datos almacenados digitalmente. Existen dos categorías principales: las bases de datos transaccionales, que manejan datos dinámicos que cambian constantemente (como inventarios), y las bases de datos analíticas, que almacenan datos estáticos que rara vez se modifican (como resultados de experimentos científicos).

Es importante notar que, estrictamente hablando, la base de datos son los datos mismos, aunque comúnmente el término se usa de forma incorrecta para referirse tanto a los datos como al Sistema de Gestión de Bases de Datos (DBMS) que permite interactuar con ellos.
- Los Albores de las Bases de Datos
- El Modelo de Archivo Plano
- El Modelo Jerárquico
- El Modelo de Red
- La Revolución Relacional
- ¿Qué es una Base de Datos Relacional?
- Tipos de Relaciones en el Modelo Relacional
- Los Principios del Modelo Relacional: Las 12 Reglas de Codd
- Evolución Posterior: Gestión de Datos Antiguos
- Tabla Comparativa de Modelos de Bases de Datos Tempranos vs. Relacional
- Preguntas Frecuentes
Los Albores de las Bases de Datos
Los primeros intentos por crear bases de datos informáticas surgieron a mediados del siglo XX, en paralelo con la evolución de las computadoras. Las versiones iniciales estaban fuertemente orientadas a archivos. Un archivo de base de datos se conocía como tabla, reflejando su estructura similar a las tablas de datos en papel. Del mismo modo, las columnas se denominaron campos y las filas, registros.
El Modelo de Archivo Plano
Las primeras bases de datos informáticas se basaban en un modelo de archivo plano. En este modelo, los registros se almacenaban en formato de texto sin relaciones definidas entre ellos. La principal limitación era que solo se podía acceder a los registros de forma secuencial. Para encontrar un registro específico, era necesario recorrer todos los registros anteriores en orden. Este modelo era viable si se necesitaba procesar todos los registros (por ejemplo, generar un informe completo), pero resultaba muy ineficiente para búsquedas o acceso a registros individuales.
El Modelo Jerárquico
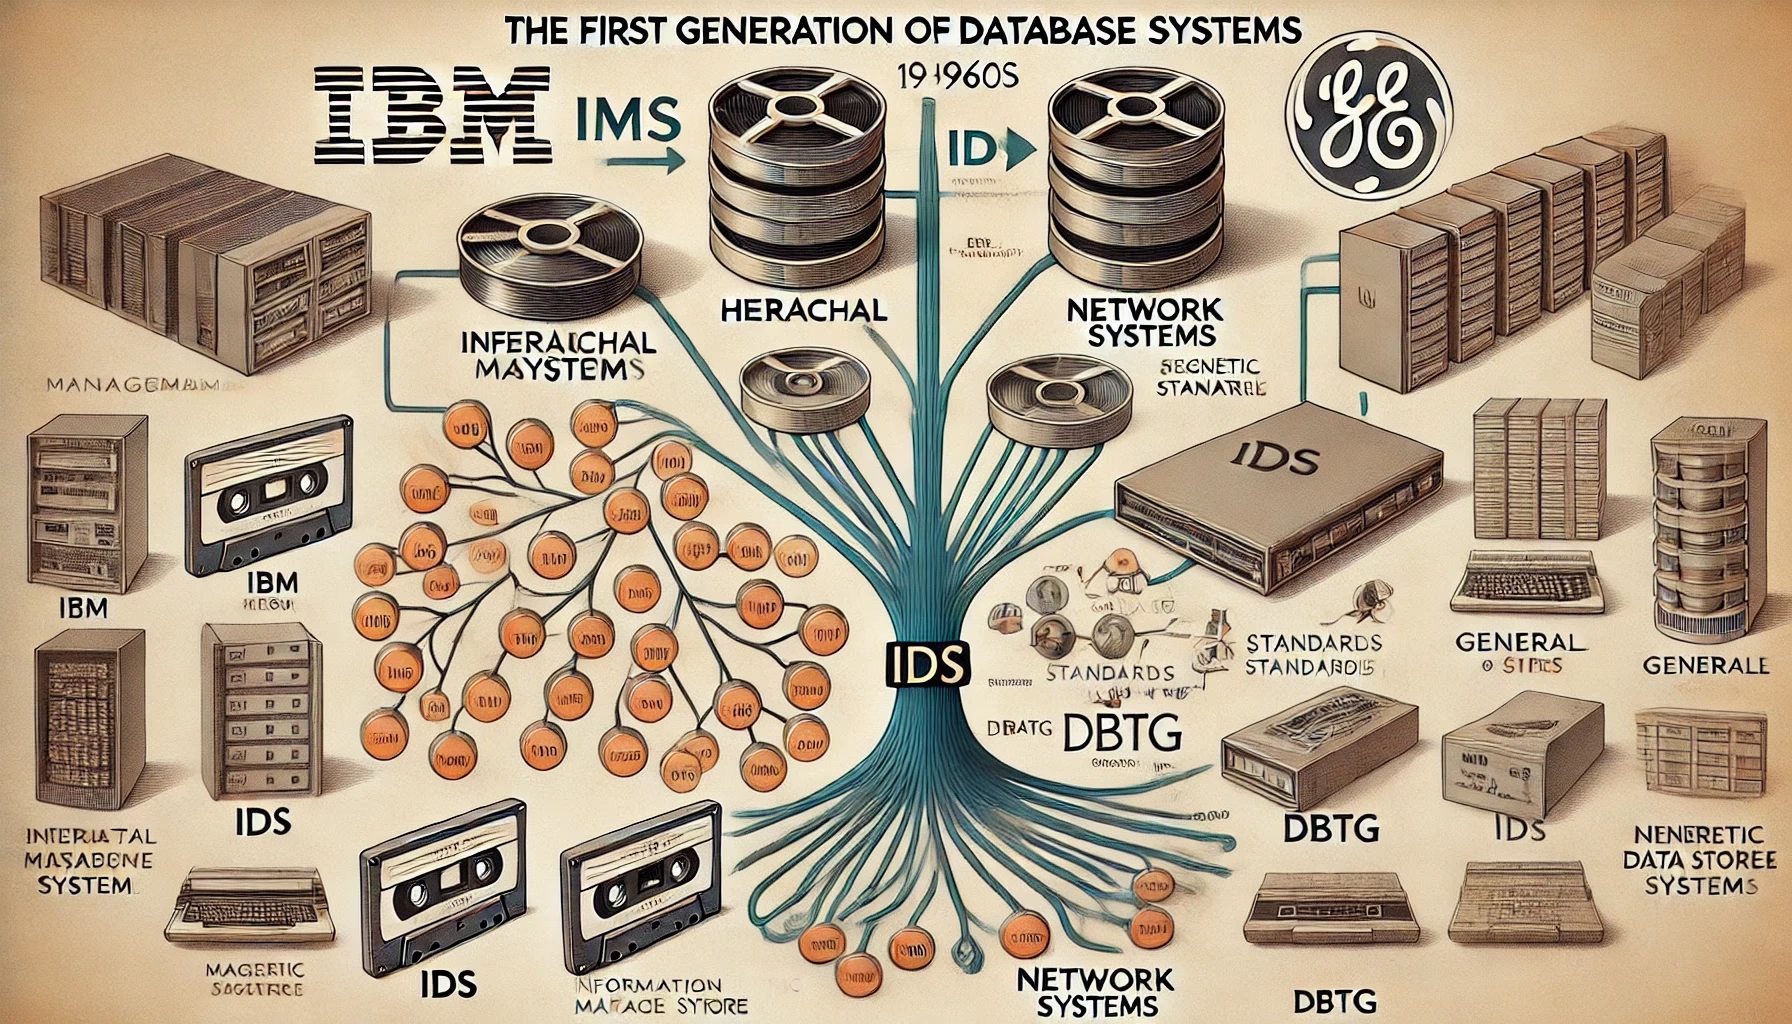
Diseñado para permitir relaciones estructuradas y facilitar la recuperación de datos, el modelo jerárquico fue ampliamente utilizado en entornos de mainframe. Se basaba en una estructura de árbol invertido con relaciones padre-hijo y de uno a muchos (1:N). Cada "padre" podía tener varios "hijos", pero cada "hijo" solo podía tener un único "padre". La recuperación de datos era rápida debido a los vínculos explícitos y permanentes entre las estructuras. Sin embargo, su rigidez presentaba problemas significativos. Por ejemplo, no se podía añadir un registro "hijo" sin un "padre" asociado. Si teníamos una tabla "Doctores" (padre) y "Pacientes" (hijo), no se podía registrar un paciente hasta que se le asignara un doctor. Además, eliminar un registro padre implicaba la eliminación automática de todos sus registros hijos vinculados, lo que podía llevar a pérdidas de datos no deseadas.
El Modelo de Red
Basado también en una estructura de árbol invertido, el modelo de red fue el siguiente paso evolutivo. Permitió conexiones más complejas que el modelo jerárquico, permitiendo que varios árboles compartieran ramas. Las tablas se conectaban en "conjuntos", donde un registro de una tabla "propietario" podía vincularse a múltiples registros de una tabla "miembro". Al igual que el modelo jerárquico, permitía una recuperación de datos muy rápida. No obstante, también tenía desventajas. Un usuario necesitaba un conocimiento profundo de la estructura de la base de datos para poder consultarla. Además, cualquier cambio en la estructura de un conjunto requería modificar los programas externos que hacían referencia a ella, lo que dificultaba el mantenimiento.
La Revolución Relacional
En la década de 1970, surgió un enfoque revolucionario para manejar los datos de formas más flexibles y complejas: la Base de Datos Relacional. Este modelo, propuesto por el Dr. E.F. Codd, un científico investigador de IBM, buscaba superar los problemas de redundancia de datos y la deficiente integridad inherentes a los modelos jerárquico y de red. Aplicando principios del cálculo relacional, el álgebra y la lógica, Codd sentó las bases para un modelo más robusto y articulado.
El Modelo Relacional finalmente dominó la industria y sigue siendo prevalente hoy en día. Uno de los objetivos de Codd era crear un lenguaje similar al inglés que permitiera a los usuarios no técnicos interactuar con la base de datos. Esto llevó al desarrollo del lenguaje SQL (Structured Query Language), que se convirtió en el estándar de facto.
¿Qué es una Base de Datos Relacional?
En el Modelo Relacional, los datos se almacenan en estructuras llamadas relaciones, que comúnmente conocemos como tablas. Los componentes fundamentales son:
- Tablas: Colecciones de datos organizados en filas y columnas.
- Registros (o Tuplas): Cada fila de una tabla, representando una entidad o un conjunto completo de datos sobre algo (por ejemplo, un cliente específico).
- Campos (o Atributos): Cada columna de una tabla, representando una propiedad o característica específica (por ejemplo, el nombre o la dirección del cliente).
Cada dato individual se almacena en un campo. Un registro contiene un conjunto completo de datos de campo para una entrada particular en la tabla. Cada registro puede ser identificado y accedido de forma única mediante una clave primaria.
Consideremos una tabla de direcciones de envío de clientes:
| ID Cliente | Nombre | Apellido | Apto. | Domicilio | Ciudad | Estado | CP |
|---|---|---|---|---|---|---|---|
| 101 | John | Smith | 147 | 123 1st Street | Chicago | IL | 60635 |
| 102 | Jane | Doe | 13 C | 234 2nd Street | Chicago | IL | 60647 |
| 103 | June | Doe | 14 A | 243 2nd Street | Chicago | IL | 60647 |
| 104 | George | Smith | N/A | 345 3rd Street | Chicago | IL | 60625 |
Aquí, "ID Cliente", "Nombre", etc., son los campos. Cada fila es un registro. El campo "ID Cliente" podría servir como clave primaria, ya que cada valor es único para identificar cada registro de cliente.
Tipos de Relaciones en el Modelo Relacional
El término "relacional" proviene de la teoría de conjuntos, aunque el modelo efectivamente funciona definiendo y explotando las relaciones entre los datos en las tablas. Las relaciones entre tablas se definen comúnmente como:
- Uno a Uno (1:1): Cada registro en la Tabla A se relaciona con exactamente un registro en la Tabla B, y viceversa. Por ejemplo, una tabla de "Clientes" y una tabla de "Detalles de Cuenta" (si cada cliente tiene solo una cuenta detallada asociada).
- Uno a Muchos (1:N): Cada registro en la Tabla A puede relacionarse con uno o más registros en la Tabla B, pero cada registro en la Tabla B se relaciona con un solo registro en la Tabla A. Un ejemplo clásico es una tabla de "Departamentos" y una tabla de "Empleados"; un departamento puede tener muchos empleados, pero cada empleado pertenece a un solo departamento.
- Muchos a Muchos (N:M): Cada registro en la Tabla A puede relacionarse con uno o más registros en la Tabla B, y cada registro en la Tabla B puede relacionarse con uno o más registros en la Tabla A. Por ejemplo, una tabla de "Estudiantes" y una tabla de "Cursos"; un estudiante puede tomar varios cursos, y un curso puede tener muchos estudiantes. Las relaciones N:M suelen implementarse mediante una tabla intermedia (o de "unión") que descompone la relación en dos relaciones 1:N.
Los Principios del Modelo Relacional: Las 12 Reglas de Codd
En 1985, el Dr. Codd publicó una lista de doce reglas (de hecho, son 13, numeradas del 0 al 12) que describían los requisitos para un sistema de base de datos relacional ideal. Aunque pocos sistemas cumplen estrictamente todas las reglas, han servido como guía fundamental para el desarrollo de DBMS relacionales.
Aquí hay un resumen de algunas de las reglas clave:
- La Regla de la Información: Toda la información (datos y metadatos) debe estar representada lógicamente en tablas.
- Acceso Garantizado: Cada dato individual debe ser lógicamente accesible de manera única especificando el nombre de la tabla, la clave primaria del registro y el nombre del campo.
- Tratamiento Sistemático de Valores Nulos: Los valores nulos (que representan datos faltantes o no aplicables) deben ser tratados de forma consistente, distinta de ceros, espacios en blanco o cadenas vacías.
- Catálogo Dinámico en Línea Basado en el Modelo Relacional: La descripción de la base de datos (el esquema o metadatos) debe almacenarse en la propia base de datos y ser accesible a través del mismo lenguaje relacional (SQL).
- Regla Completa de Sublenguaje de Datos: El sistema debe soportar al menos un lenguaje relacional que sea completo para todas las operaciones (creación, modificación y recuperación de datos y esquema). SQL es el ejemplo principal.
- Regla de Actualización de Vistas: Todas las vistas que teóricamente se puedan actualizar deben ser actualizables por el sistema.
- Inserción, Actualización y Eliminación de Alto Nivel: El sistema debe soportar operaciones de inserción, actualización y eliminación en conjuntos de datos, no solo en registros individuales.
- Independencia Física de los Datos: Los cambios en la forma en que se almacenan físicamente los datos no deben afectar las aplicaciones ni la forma en que los usuarios ven los datos.
- Independencia Lógica de los Datos: Los cambios en la estructura lógica de las tablas (como añadir o eliminar columnas, siempre que no afecten a las columnas existentes) no deben requerir cambios en las aplicaciones que no hagan referencia a las columnas modificadas.
- Independencia de Integridad: Las restricciones de integridad (como claves primarias, claves foráneas, reglas de negocio) deben definirse en el lenguaje relacional y almacenarse en el catálogo, no en programas de aplicación.
- Independencia de Distribución: Si la base de datos está distribuida físicamente en múltiples ubicaciones, esto debe ser transparente para el usuario y las aplicaciones.
- Regla de No Subversión: No debe ser posible "saltarse" las reglas de integridad o las restricciones de seguridad utilizando lenguajes de bajo nivel.
Estas reglas establecieron un estándar elevado que impulsó el desarrollo de sistemas de gestión de bases de datos relacionales robustos y flexibles.
Evolución Posterior: Gestión de Datos Antiguos
Aunque el modelo relacional resolvió muchos problemas de los sistemas anteriores, el manejo de grandes volúmenes de datos históricos siguió siendo un desafío, especialmente a medida que las bases de datos crecían exponencialmente. En los sistemas relacionales modernos, particularmente con la introducción de características como las tablas temporales con versiones del sistema (disponibles en SQL Server 2016+ y Azure SQL Database), se han desarrollado enfoques más sofisticados para gestionar la retención de datos históricos, contrastando con la gestión a menudo manual o difícil de los sistemas más primitivos.
Algunos de estos enfoques modernos incluyen:
- Particionamiento de Tablas: Permite dividir tablas grandes en partes más pequeñas y manejables. Esto es útil para implementar políticas de retención por tiempo, permitiendo "desconectar" o eliminar particiones antiguas de datos históricos de manera eficiente.
- Scripts de Limpieza Personalizados: Aunque menos automatizado que el particionamiento o las políticas de retención automáticas, implica ejecutar scripts (típicamente durante ventanas de mantenimiento) para eliminar datos históricos que superan un cierto umbral de antigüedad. En sistemas que lo permiten, esto requiere desactivar temporalmente el versionado o realizar la operación dentro de una transacción cuidadosa para no afectar la consistencia.
- Política de Retención de Historial Temporal: En sistemas más recientes, se puede configurar una política de retención directamente en la definición de la tabla temporal (por ejemplo, "mantener historial por 6 meses"). El sistema de gestión de base de datos se encarga automáticamente de identificar y limpiar los datos antiguos en segundo plano.
Estos métodos modernos para gestionar datos históricos ilustran cuánto han evolucionado las capacidades de gestión de bases de datos desde los días de los archivos planos y las estructuras rígidas, construyendo sobre los sólidos fundamentos del modelo relacional para abordar los desafíos de la escala y la retención de datos en el mundo actual.
Tabla Comparativa de Modelos de Bases de Datos Tempranos vs. Relacional
| Característica | Archivo Plano | Jerárquico | Red | Relacional |
|---|---|---|---|---|
| Estructura | Secuencial, sin estructura interna definida | Árbol invertido (padre-hijo) | Grafo (conexiones múltiples) | Colección de tablas (relaciones) |
| Acceso | Principalmente secuencial | Rápido si se sigue la estructura (padre a hijo) | Rápido si se sigue la estructura definida (conjuntos) | Acceso flexible y basado en contenido mediante consultas |
| Relaciones | Ninguna definida | Uno a Muchos (1:N) | Uno a Muchos (1:N), Muchos a Muchos (N:M) a través de conjuntos | Uno a Uno (1:1), Uno a Muchos (1:N), Muchos a Muchos (N:M) a través de claves |
| Flexibilidad | Muy baja | Baja (estructura rígida) | Moderada (más flexible que jerárquico, pero compleja) | Alta (estructura lógica independiente del acceso físico) |
| Redundancia/Integridad | Alta redundancia, baja integridad | Potencial de redundancia, problemas de integridad con eliminaciones | Potencial de redundancia, complejidad para mantener integridad | Baja redundancia (bien diseñado), alta integridad (mediante restricciones) |
Preguntas Frecuentes
¿Por qué el modelo relacional se volvió tan dominante?
El modelo relacional ofreció una mayor flexibilidad y una forma más intuitiva de organizar y consultar datos en comparación con los modelos jerárquico y de red. Su base matemática sólida permitió el desarrollo de lenguajes de consulta potentes y declarativos como SQL, que abstrajeron la complejidad del acceso a datos de la estructura física. Resolvió los problemas de redundancia y mejoró la integridad de los datos.
¿Cuáles fueron los principales problemas de los modelos jerárquico y de red?
Ambos modelos sufrían de estructuras rígidas que dificultaban los cambios y la representación de relaciones complejas (especialmente N:M para el jerárquico). Requerían que los usuarios o programadores tuvieran un conocimiento profundo de la estructura física de la base de datos para acceder a los datos. Además, manejar la redundancia y garantizar la integridad de los datos era complicado.
¿Qué es una clave primaria?
Una clave primaria es uno o más campos en una tabla que identifican de forma única cada registro. Es fundamental en el modelo relacional para garantizar la integridad de la entidad y permitir la creación de relaciones con otras tablas.
¿Qué papel jugó SQL en la popularización del modelo relacional?
SQL proporcionó un lenguaje estándar, relativamente fácil de aprender y usar, para interactuar con bases de datos relacionales. Su naturaleza declarativa (el usuario especifica qué datos quiere, no cómo obtenerlos) lo hizo accesible para una audiencia más amplia y facilitó el desarrollo de aplicaciones.
¿Las bases de datos NoSQL son un regreso a los modelos pre-relacionales?
Aunque las bases de datos NoSQL (Not only SQL) a menudo renuncian a algunas de las estrictas características del modelo relacional (como esquemas fijos o uniones complejas) para ganar escalabilidad o flexibilidad en ciertos escenarios, no son un simple regreso a los modelos antiguos. Representan una diversificación de enfoques para manejar tipos específicos de datos o cargas de trabajo que no encajan bien en el modelo relacional tradicional, pero se benefician de décadas de experiencia en gestión de datos.
Desde los modestos inicios con archivos planos hasta la sofisticación del Modelo Relacional y las técnicas modernas de gestión de datos, la evolución de las bases de datos es una historia de cómo la informática ha aprendido a organizar, acceder y proteger la información de manera eficiente. El legado del Dr. Codd y el SQL perdura como la base de gran parte de la infraestructura de datos actual.
Si quieres conocer otros artículos parecidos a De Archivos Planos a la Era Relacional puedes visitar la categoría Bases de datos.

Aprende mas sobre MySQL