

En el vertiginoso mundo del desarrollo de software, la forma en que almacenamos e intercambiamos datos es tan crucial como las aplicaciones que construimos. Durante décadas, las bases de datos relacionales con sus estructuras rígidas dominaron el panorama. Sin embargo, la explosión de datos no estructurados y semiestructurados, junto con la necesidad de agilidad y escalabilidad horizontal, impulsó la adopción de las bases de datos NoSQL. Y en el corazón de muchas de estas bases de datos, especialmente las documentales, encontramos un formato de datos que ha revolucionado la forma en que pensamos sobre la estructura: JSON.

JSON, acrónimo de JavaScript Object Notation, es un formato ligero de intercambio de datos. Aunque su nombre proviene de JavaScript, JSON es completamente independiente del lenguaje. Se basa en una colección de pares clave-valor y una lista ordenada de valores (arrays). Su simplicidad y legibilidad humana lo hicieron rápidamente popular para la comunicación entre servidores web y navegadores, reemplazando a menudo a XML.
- ¿Por Qué JSON Es Clave en el Ecosistema NoSQL?
- La Versatilidad de JSON: Más Allá de la Web
- ¿Por Qué JSON Conquista a los Desarrolladores?
- JSON Binario en el Mundo NoSQL: El Caso de MongoDB
- Profundizando en MongoDB: Cómo Funciona
- Alta Disponibilidad y Escalabilidad con MongoDB
- MongoDB vs. Bases de Datos Relacionales: Una Comparativa
- Preguntas Frecuentes sobre JSON y NoSQL
- Conclusión
¿Por Qué JSON Es Clave en el Ecosistema NoSQL?
La principal razón por la que JSON encaja tan bien con muchas bases de datos NoSQL, particularmente las que siguen un modelo de documento, es su naturaleza flexible y auto-descriptiva. A diferencia de las bases de datos relacionales donde se debe definir un esquema fijo antes de insertar datos, las bases de datos documentales permiten almacenar documentos con estructuras variadas dentro de la misma "colección". Un documento JSON puede tener diferentes campos o anidamientos que otro, sin requerir una modificación del esquema central de la base de datos. Esto se alinea perfectamente con las necesidades de aplicaciones modernas que manejan datos dinámicos o que evolucionan rápidamente.
Imagina una aplicación de comercio electrónico. Un producto puede tener campos como 'nombre', 'precio', 'descripción', 'categoría'. Pero un tipo de producto (por ejemplo, un libro) podría tener campos adicionales como 'autor' y 'ISBN', mientras que otro (por ejemplo, una camiseta) podría tener 'tallas' y 'colores'. En una base de datos relacional, esto a menudo requeriría tablas separadas o columnas nulas. En una base de datos documental que usa JSON, simplemente almacenas cada producto como un documento JSON, y cada documento contiene solo los campos relevantes para ese producto específico. Esta flexibilidad acelera el desarrollo y facilita la adaptación a los cambios en los requisitos del negocio.
La Versatilidad de JSON: Más Allá de la Web
La naturaleza independiente del lenguaje de JSON lo convierte en un formato ideal para intercambiar datos a través de diferentes lenguajes de programación y plataformas. Por ejemplo, una aplicación escrita en Java puede enviar fácilmente datos JSON a una aplicación Python. O una aplicación móvil escrita en JavaScript puede usar JSON para comunicarse con un servidor back-end escrito en PHP. ¿Por qué? Porque ambos sistemas pueden analizar y generar JSON utilizando bibliotecas estándar disponibles en prácticamente todos los lenguajes.
Más allá del desarrollo web y la comunicación entre servicios, JSON se utiliza a menudo dentro de una aplicación o un sistema de TI para almacenar y gestionar los valores de configuración. Por ejemplo, los archivos de configuración escritos en formato JSON pueden contener información esencial, como detalles de conexión de base de datos, claves de API o preferencias de usuario. Al almacenar los datos de configuración en archivos JSON simples, fáciles de leer y analizar, los desarrolladores pueden modificar la configuración de la aplicación sin necesidad de cambios de código. Esto promueve la separacion de la configuración y la lógica de la aplicación, facilitando la gestión de diferentes entornos (desarrollo, staging, producción).
¿Por Qué JSON Conquista a los Desarrolladores?
JSON ha ganado una inmensa popularidad entre los desarrolladores por varias razones clave:
- Es Basado en Texto y Ligero: Es fácil de leer y escribir tanto para humanos como para máquinas. Su estructura minimalista lo hace eficiente para la transmisión de datos a través de redes.
- Amplio Soporte: Prácticamente todos los lenguajes de programación modernos tienen bibliotecas robustas para analizar (parsear) y serializar (generar) datos JSON. Esto elimina la necesidad de código adicional complejo para trabajar con este formato.
- Formato de Datos Fácil de Analizar: La estructura jerárquica de clave-valor y arrays se mapea de forma natural a las estructuras de datos nativas en la mayoría de los lenguajes de programación (como diccionarios/objetos y listas/arrays), lo que facilita su manipulación programática.
- Ideal para APIs y Microservicios: JSON se ha convertido en el formato de facto para las APIs RESTful, permitiendo un intercambio de datos rápido y eficiente entre diferentes servicios. Su naturaleza ligera es perfecta para arquitecturas de microservicios.
- Integración con Bases de Datos NoSQL: Como mencionamos, la alineación natural de JSON con el modelo de documento lo hace extremadamente conveniente para trabajar con bases de datos NoSQL documentales. Los datos a menudo se almacenan en un formato muy similar a JSON (o una variante binaria) y se recuperan de la misma manera, minimizando la necesidad de transformaciones.
Incluso las populares bases de datos relacionales ahora pueden manejar JSON como un tipo de dato nativo (por ejemplo, PostgreSQL, MySQL, SQL Server), abriendo aún más aplicaciones a las ventajas de usar JSON para ciertos tipos de datos, aunque todavía dentro de la estructura general de la tabla relacional.
JSON Binario en el Mundo NoSQL: El Caso de MongoDB
Si bien JSON es excelente por su legibilidad, para el almacenamiento y procesamiento eficiente a gran escala en bases de datos se necesita a menudo un formato binario. Aquí es donde entra BSON (Binary JSON), un formato de serialización binaria que se utiliza principalmente en MongoDB. BSON extiende JSON al incluir tipos de datos adicionales (como Date, BinData, ObjectId, etc.) que no están disponibles en JSON estándar y está diseñado para ser recorrido y manipulado de manera más eficiente por software.
MongoDB es una de las bases de datos NoSQL documentales más populares que utiliza BSON para almacenar sus datos. Aunque interactúas con MongoDB usando algo muy parecido a JSON en tus consultas y la base de datos te devuelve resultados que parecen JSON, internamente los datos se almacenan y procesan en BSON. Esta elección permite a MongoDB ofrecer un rendimiento superior para operaciones de lectura y escritura, así como un uso más eficiente del espacio de almacenamiento en comparación con el almacenamiento directo de texto JSON.
Profundizando en MongoDB: Cómo Funciona
MongoDB almacena datos en colecciones, que son análogas a las tablas en las bases de datos relacionales. Cada colección contiene múltiples documentos, que son la unidad fundamental de datos. Estos documentos son estructuras BSON (similares a JSON) y, como mencionamos, pueden variar en estructura dentro de la misma colección. No es necesario declarar la estructura de los documentos al sistema (esto es lo que se conoce como esquema flexible o "schema-less"), ya que los documentos son auto-descriptivos: cada documento contiene metadatos que describen cada campo dentro del documento.
Para mejorar el rendimiento, MongoDB soporta la creación de índices en cualquier campo de un documento. Los índices permiten la ejecución eficiente de consultas y pueden incluir índices primarios (el campo `_id` por defecto) y secundarios. El lenguaje de consulta de MongoDB (MQL - MongoDB Query Language) soporta las operaciones CRUD (Create, Read, Update, Delete) y permite consultas complejas, búsqueda de texto y consultas geoespaciales. MQL utiliza una sintaxis similar a JavaScript, lo que lo hace familiar para muchos desarrolladores web.
Para ayudar a mejorar los tiempos de respuesta y realizar análisis complejos, MongoDB proporciona un framework de agregación, que permite a los desarrolladores configurar procesamiento de datos complejos en el lado del servidor. Esto significa que es capaz de realizar análisis directamente en el clúster donde residen los datos, sin tener que moverlos a otra plataforma. Esto puede reducir significativamente la cantidad de datos que se transfieren a y desde los clientes.
Alta Disponibilidad y Escalabilidad con MongoDB
MongoDB está diseñado para proporcionar alta disponibilidad y mejorar el rendimiento mediante el soporte de conjuntos de réplicas (replica sets). Un conjunto de réplicas es un grupo de procesos de servidor MongoDB que mantienen el mismo conjunto de datos. Las réplicas pueden utilizarse para balanceo de carga al distribuir las operaciones de lectura entre las instancias secundarias. Estos conjuntos de réplicas también proporcionan redundancia y aumentan la disponibilidad de los datos a través de múltiples copias de los datos en diferentes servidores de base de datos. En caso de fallo de hardware o mantenimiento, los conjuntos de réplicas permiten a MongoDB proporcionar conmutación por error automática (automatic failover) y redundancia de datos.
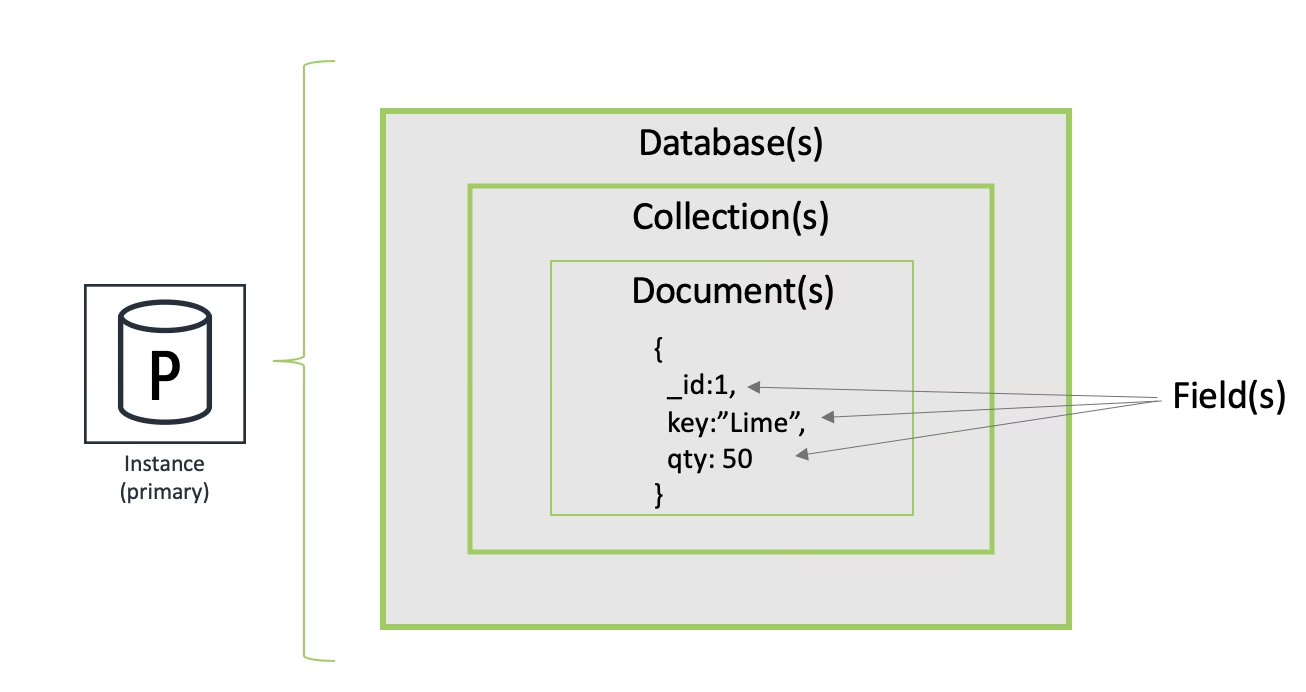
Para la escalabilidad, MongoDB soporta la escalabilidad horizontal a través del sharding. El sharding es una forma de distribuir datos a través de múltiples bases de datos en múltiples máquinas. Un clúster shardeado puede consistir en muchos conjuntos de réplicas. El sharding se configura definiendo una clave de shard, que determina cómo se distribuyen los datos entre los shards. Esta técnica ayuda a gestionar grandes conjuntos de datos y operaciones de alto rendimiento al dividir el conjunto de datos y la carga entre varios servidores.
Cada shard es una instancia de base de datos independiente que aloja subconjuntos de los datos de una base de datos shardeada. Las solicitudes de los clientes son manejadas por procesos especiales llamados `mongos` (routers de consulta) que dirigen las operaciones al shard o shards correctos. Esta arquitectura distribuida permite a MongoDB escalar casi linealmente con la adición de más servidores.
MongoDB vs. Bases de Datos Relacionales: Una Comparativa
Cada tipo de base de datos, ya sean relacionales (como MySQL, PostgreSQL, Oracle) o documentales (como CouchDB, DynamoDB, MongoDB), tiene fortalezas y debilidades. La elección entre ellas generalmente depende de los requisitos y restricciones específicos de la aplicación que se está desarrollando.
Un sistema de gestión de bases de datos relacionales (RDBMS) utiliza un Lenguaje de Consulta Estructurado (SQL), mientras que el formato centrado en documentos de MongoDB utiliza APIs de almacenamiento de documentos y su propio lenguaje de consulta (MQL). A pesar de las diferencias sintácticas, MQL soporta operaciones fundamentales similares a SQL para manipular datos.
Como se mencionó, MongoDB no tiene el concepto de tablas y filas, y carece de un esquema central fijo. Esto significa que hay menos estructura que definir antes de que la base de datos pueda ser utilizada, lo que acelera el inicio del desarrollo. Sin embargo, la "estructura" o "esquema" reside en el código de la aplicación. Si una aplicación cambia la estructura de los documentos, otras aplicaciones que accedan a la misma colección deben estar preparadas para manejar esa variación, lo que puede requerir coordinación. En comparación, en las bases de datos relacionales, el esquema es una especie de plano que define explícitamente la organización y las interrelaciones de los datos, y la base de datos aplica esta estructura, ayudando a garantizar la integridad de los datos a nivel de la base de datos misma.
La flexibilidad de los almacenes de datos es notable en MongoDB, ya que utiliza formatos como documentos (BSON), y las estructuras de datos pueden cambiar con el tiempo. Esto difiere de un RDBMS, que utiliza definiciones estrictas, jerarquías y procedimientos de validación basados en el esquema definido para ayudar a garantizar la integridad de los datos. Las relaciones entre datos en MongoDB suelen manejarse mediante referencias (guardando IDs de documentos relacionados) y se gestionan a nivel de aplicación, a diferencia de las relaciones explícitamente definidas y gestionadas por el motor de la base de datos en un RDBMS (claves foráneas).
Si bien configurar una instancia básica de MongoDB es sencillo, configurar y mantener un clúster distribuido a gran escala con sharding y réplicas puede ser complejo y requiere una buena comprensión de su arquitectura y opciones de configuración. Un RDBMS, aunque requiere una planificación inicial de esquema más rigurosa, a menudo tiene una complejidad de administración a gran escala diferente, centrada en la optimización de consultas, la normalización y la gestión de transacciones complejas.
Aquí tienes una tabla comparativa que resume algunas diferencias clave:
| Característica | Base de Datos Relacional (RDBMS) | Base de Datos Documental (MongoDB) |
|---|---|---|
| Modelo de Datos | Tablas con filas y columnas | Colecciones de documentos (JSON/BSON) |
| Esquema | Rígido, predefinido | Flexible, dinámico (schema-on-read) |
| Lenguaje de Consulta | SQL | MQL (similar a JavaScript), APIs |
| Relaciones | Definidas y gestionadas por la DB (claves foráneas) | Generalmente gestionadas por la aplicación (referencias) |
| Escalabilidad Principal | Vertical (generalmente) | Horizontal (sharding) |
| Integridad de Datos | Aplicada por la DB (esquema, restricciones) | Generalmente gestionada por la aplicación |
| Complejidad (Gran Escala) | Optimización de consultas, normalización, transacciones | Configuración de sharding, réplicas distribuidas |
Preguntas Frecuentes sobre JSON y NoSQL
¿Es BSON exactamente lo mismo que JSON?
No. BSON es una representación binaria de JSON. Es similar en estructura (pares clave-valor, arrays) pero incluye tipos de datos adicionales y está optimizado para el almacenamiento y recorrido eficiente dentro de una base de datos como MongoDB. Puedes convertir JSON a BSON y viceversa, pero no son idénticos.
¿Puede una base de datos relacional usar JSON?
Sí, muchas bases de datos relacionales modernas como PostgreSQL, MySQL y SQL Server tienen tipos de datos nativos para JSON y funciones para manipular datos JSON dentro de las columnas de una tabla. Esto permite almacenar datos semiestructurados dentro de un modelo relacional, pero no ofrece la misma flexibilidad de esquema a nivel de documento que una base de datos puramente documental.
¿Es JSON la única forma de almacenar datos en NoSQL?
No. El término NoSQL abarca una amplia variedad de bases de datos con diferentes modelos de datos. Existen bases de datos de clave-valor, de columna ancha, de grafos, etc., que utilizan formatos de datos diferentes a JSON. Sin embargo, JSON (o formatos similares como BSON) es fundamental para las bases de datos documentales, que son un subconjunto importante del panorama NoSQL.
¿Siempre debo usar MongoDB si mis datos son JSON?
No necesariamente. MongoDB es una excelente opción para muchos casos de uso, especialmente cuando se necesita flexibilidad de esquema y escalabilidad horizontal para datos basados en documentos. Sin embargo, la elección de la base de datos depende de muchos factores, incluyendo los patrones de acceso a los datos, los requisitos de consistencia, la complejidad de las consultas y la experiencia del equipo. Otras bases de datos documentales (CouchDB, DynamoDB) o incluso bases de datos relacionales con soporte JSON podrían ser más adecuadas dependiendo del contexto.
Conclusión
JSON ha demostrado ser un formato de datos increíblemente poderoso y adaptable para el mundo moderno del desarrollo de software. Su simplicidad, legibilidad e independencia del lenguaje lo convierten en una opción ideal para el intercambio de datos y la configuración. En el ámbito de las bases de datos NoSQL, especialmente las documentales, JSON (y su variante binaria BSON en el caso de MongoDB) es fundamental. Permite la flexibilidad de esquema necesaria para manejar datos dinámicos, acelera el ciclo de desarrollo y se integra perfectamente con las arquitecturas distribuidas. Comprender JSON y su papel en bases de datos como MongoDB es esencial para cualquier desarrollador que trabaje con aplicaciones escalables y basadas en datos en la actualidad.
Si quieres conocer otros artículos parecidos a JSON en NoSQL: Flexibilidad y Poder en Datos puedes visitar la categoría Bases de datos.
Aprende mas sobre MySQL