
En el dinámico mundo de los sistemas distribuidos, donde múltiples usuarios y procesos acceden y modifican datos simultáneamente a través de diversas ubicaciones geográficas o nodos, surge un desafío fundamental: el control de la concurrencia. La concurrencia es la capacidad de un sistema para ejecutar múltiples tareas al mismo tiempo aparente o real. Es crucial garantizar que estas operaciones simultáneas no interfieran entre sí de manera que conduzcan a inconsistencias o errores en los datos almacenados.

A menudo, se confunde la concurrencia con el paralelismo. Aunque relacionados, no son lo mismo. El paralelismo implica la ejecución literal de múltiples tareas en distintos procesadores o núcleos de CPU al mismo tiempo, mientras que la concurrencia se refiere a la gestión de múltiples tareas que pueden estar progresando en un período de tiempo, incluso si solo una se ejecuta en un instante dado (por ejemplo, mediante el cambio rápido de contexto en un solo procesador). En el contexto de las bases de datos distribuidas, la concurrencia se centra en asegurar que, a pesar de la ejecución entrelazada de transacciones, el resultado final sea equivalente a alguna ejecución serial de las mismas transacciones.
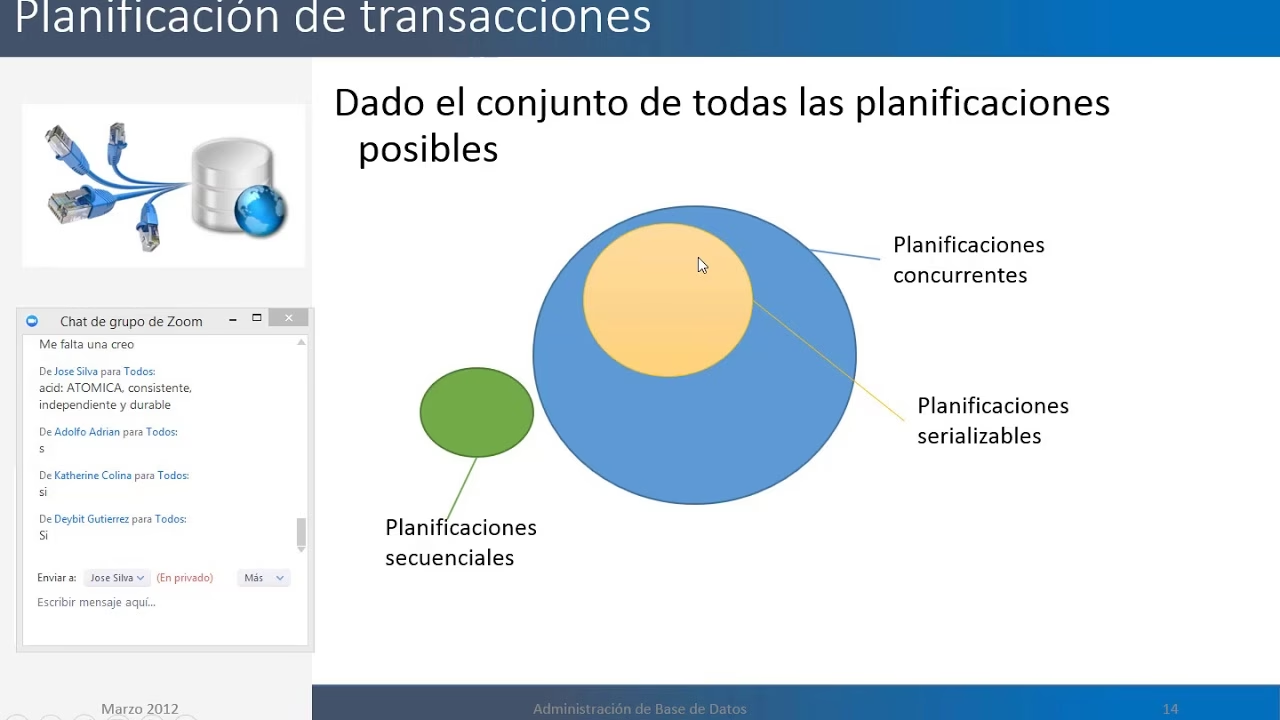
Existen dos enfoques principales para abordar el control de concurrencia en sistemas, incluidas las bases de datos distribuidas: el Control de Concurrencia Optimista y el Control de Concurrencia Pesimista. Cada uno tiene su filosofía y sus mecanismos asociados, diseñados para manejar los conflictos que inevitablemente surgen cuando varios actores intentan interactuar con los mismos datos.
Control de Concurrencia Optimista (OCC)
El Control de Concurrencia Optimista, conocido como OCC (Optimistic Concurrency Control), adopta una postura de 'pedir perdón, no permiso'. Asume que los conflictos entre transacciones son poco frecuentes. Bajo este enfoque, las transacciones proceden de manera optimista, ejecutándose sin adquirir bloqueos preventivos sobre los datos que leen o modifican. La detección de conflictos se realiza durante la fase de confirmación (commit). Si en esta fase se detecta que otra transacción ha modificado los datos que la transacción actual leyó o intentó modificar, la transacción optimista se aborta y, a menudo, se reintenta.
En un entorno distribuido, la implementación del OCC a menudo implica mantener información de versión para cada elemento de datos. Cada transacción comienza leyendo una instantánea consistente de la base de datos. Al intentar confirmar, verifica si alguno de los elementos de datos que leyó o modificó ha sido alterado por otra transacción desde que comenzó. Si se detectan conflictos, la transacción se revierte y se reintenta con una nueva instantánea, reflejando el estado actual de los datos.
Dentro del Control de Concurrencia Optimista, encontramos varios mecanismos específicos:
Snapshot Isolation
La Aislamiento por Instantánea (Snapshot Isolation) garantiza que cada transacción vea una instantánea consistente de la base de datos tal como estaba al comienzo de la transacción. Esto significa que una transacción lee los datos sin verse afectada por las modificaciones de otras transacciones que se confirman mientras la suya se ejecuta. Para lograr esta forma de aislamiento, se utilizan métodos como el Control de Concurrencia Multiversión (MVCC) y la Ordenación por Marcas de Tiempo.
MVCC (Multi-Version Concurrency Control)
El Control de Concurrencia Multiversión (MVCC) es un mecanismo clave para implementar Snapshot Isolation. MVCC mantiene múltiples versiones de los datos, permitiendo que las transacciones de lectura accedan a una versión consistente sin bloquear las transacciones de escritura. Las transacciones de escritura crean nuevas versiones de los datos modificados. Un ejemplo clásico es un sistema bancario: varios usuarios pueden transferir fondos concurrentemente entre cuentas sin bloquearse mutuamente. Cada transacción opera sobre su propia versión de los saldos de cuenta, asegurando la consistencia al momento de la confirmación. Las lecturas no bloquean las escrituras, y las escrituras no bloquean las lecturas de versiones antiguas.
Timestamp Ordering
La Ordenación por Marcas de Tiempo (Timestamp Ordering) asigna marcas de tiempo únicas a las transacciones y fuerza un orden total en su ejecución. Este orden se basa en el momento en que cada transacción comenzó. Si una transacción intenta leer un dato que ha sido modificado por una transacción con una marca de tiempo posterior, o intenta modificar un dato que ha sido leído o modificado por una transacción con una marca de tiempo posterior, puede ocurrir un conflicto que resulte en el aborto de la transacción actual para mantener el orden basado en las marcas de tiempo. En un sistema distribuido, las transacciones para procesar pedidos de clientes reciben marcas de tiempo. El sistema asegura que el procesamiento de pedidos siga el orden de estas marcas de tiempo para evitar conflictos y mantener la consistencia.
CRDT (Conflict-Free Replicated Data Type)
Los Tipos de Datos Replicados Libres de Conflictos (CRDT) son estructuras de datos distribuidas diseñadas para permitir actualizaciones concurrentes sin necesidad de coordinación centralizada o algoritmos de consenso complejos. Los CRDTs están diseñados para manejar conflictos que surgen cuando varios usuarios modifican simultáneamente el mismo dato. Su naturaleza permite que las réplicas se actualicen de forma independiente y luego se fusionen sin pérdida de información o inconsistencias. Un caso de uso común es la edición colaborativa en tiempo real, donde múltiples usuarios editan un documento compartido simultáneamente. Las operaciones de edición se aplican localmente y luego se propagan a otras réplicas, y los CRDTs aseguran que, eventualmente, todas las réplicas converjan al mismo estado consistente.
Control de Concurrencia Pesimista (PCC)
El Control de Concurrencia Pesimista, o PCC (Pessimistic Concurrency Control), opera bajo la suposición de que los conflictos son probables y deben prevenirse activamente. Adopta un enfoque de 'pedir permiso' adquiriendo bloqueos sobre los recursos (datos) antes de acceder a ellos. Esto asegura que las transacciones obtengan acceso exclusivo a los recursos, impidiendo que otras transacciones los modifiquen o accedan hasta que los bloqueos sean liberados. Si una transacción intenta adquirir un bloqueo sobre un recurso que ya está bloqueado por otra transacción, debe esperar hasta que el bloqueo sea liberado.
En un sistema distribuido, el PCC puede implementarse utilizando bloqueos distribuidos o gestores de bloqueos. Cuando una transacción necesita acceder a un recurso, solicita un bloqueo sobre ese recurso a un gestor de bloqueos (que puede ser distribuido). Si el bloqueo está disponible, se otorga y la transacción procede. Si el bloqueo no está disponible, la transacción espera hasta que se libere.
Varios mecanismos se utilizan en el Control de Concurrencia Pesimista:
Two-Phase Locking (2PL)
El Bloqueo de Dos Fases (2PL) es un protocolo de control de concurrencia que asegura la serializabilidad de las transacciones. Consiste en dos fases: una fase de crecimiento (growing phase) donde la transacción adquiere todos los bloqueos necesarios pero no libera ninguno, y una fase de decrecimiento (shrinking phase) donde la transacción libera bloqueos pero no adquiere ninguno nuevo. Todos los bloqueos deben adquirirse antes de que se libere el primero. En una base de datos compartida, cuando un usuario quiere actualizar una fila específica, 2PL asegura que otros usuarios no puedan acceder o modificar la misma fila hasta que el bloqueo sea liberado, previniendo conflictos. Una vez que la transacción comienza a liberar bloqueos, no puede adquirir más.
Strict Two-Phase Locking (Strict 2PL)
El Bloqueo Estricto de Dos Fases (Strict 2PL) es una variante de 2PL que ofrece un nivel de aislamiento más fuerte, específicamente el aislamiento de confirmación serializable (serializable commitment). En Strict 2PL, todos los bloqueos adquiridos por una transacción se mantienen hasta que la transacción se confirma (commit) o se aborta (rollback). Esto previene que otras transacciones lean o escriban datos modificados por una transacción que aún no se ha confirmado, evitando así los problemas de 'lectura sucia' y 'lectura no repetible', y asegurando que si una transacción aborta, sus cambios puedan ser deshechos sin afectar a otras transacciones que ya hayan leído esos datos. En una base de datos distribuida, una transacción bloquea todos los recursos necesarios (tablas, filas) al principio y mantiene los bloqueos hasta que finaliza, asegurando que ninguna otra transacción acceda o modifique los recursos bloqueados.
Multiple Granularity Locking
El Bloqueo de Granularidad Múltiple (Multiple Granularity Locking) permite adquirir bloqueos en diferentes niveles de granularidad dentro de la estructura de la base de datos, como a nivel de tabla, a nivel de página o a nivel de fila. Esto ofrece flexibilidad. Adquirir un bloqueo a nivel de tabla es menos granular pero más eficiente si una transacción necesita acceder a la mayoría de las filas de la tabla. Adquirir un bloqueo a nivel de fila es más granular, permitiendo mayor concurrencia para otras transacciones que accedan a filas diferentes en la misma tabla, pero implica más sobrecarga de gestión de bloqueos. En un sistema de base de datos, una transacción puede adquirir un bloqueo a nivel de fila para un registro específico que quiere actualizar, impidiendo que otras transacciones modifiquen ese mismo registro, pero permitiendo acceso concurrente a otros registros en la misma tabla.
Distributed Lock Manager (DLM)
Un Gestor de Bloqueos Distribuidos (DLM) es un componente crucial para implementar PCC en sistemas distribuidos. Es responsable de coordinar la adquisición y liberación de bloqueos a través de múltiples nodos. Cuando una transacción en un nodo necesita un recurso, solicita un bloqueo al DLM. El DLM mantiene el estado de todos los bloqueos a través del sistema distribuido y otorga o deniega las solicitudes de bloqueo. Si el recurso ya está bloqueado por otra transacción en otro nodo, el DLM hace que la transacción solicitante espere. Por ejemplo, en un sistema de archivos distribuido, el DLM coordina el acceso a archivos compartidos para prevenir conflictos. Asegura que solo un cliente tenga un bloqueo exclusivo sobre un archivo a la vez para evitar corrupción o inconsistencias causadas por modificaciones concurrentes.
Elección entre OCC y PCC
La decisión de utilizar Control de Concurrencia Optimista o Pesimista depende de varios factores, incluyendo las características de la carga de trabajo, el nivel de contención (qué tan frecuentemente las transacciones intentan acceder a los mismos datos simultáneamente) y el nivel deseado de concurrencia y rendimiento.
El OCC es a menudo favorecido cuando se espera que los conflictos sean poco frecuentes. Permite una mayor concurrencia porque las transacciones no se bloquean mutuamente al principio. Sin embargo, si los conflictos son frecuentes, el OCC puede resultar en muchas transacciones abortadas y reintentadas, lo que puede degradar el rendimiento.
El PCC es preferible cuando se anticipa que los conflictos serán frecuentes. Aunque puede reducir la concurrencia al hacer que las transacciones esperen por bloqueos, previene el trabajo desperdiciado de las transacciones abortadas. El costo es una potencial mayor cantidad de bloqueos y esperas.
Por ejemplo, una solución de comercio electrónico podría optar por OCC bajo condiciones normales, donde la mayoría de las transacciones acceden a diferentes productos o inventarios. Sin embargo, podría cambiar a PCC cuando hay una ráfaga de demanda para un artículo específico en oferta (un 'hot sku'), o usar PCC solo cuando el inventario de un artículo alcanza un umbral bajo. Esto ilustra cómo la elección puede ser dinámica y depender del contexto.
En resumen, ambos enfoques tienen sus méritos y se eligen en función del equilibrio deseado entre concurrencia y el costo de manejar conflictos en un entorno distribuido.
Tabla Comparativa: OCC vs PCC
| Característica | Control de Concurrencia Optimista (OCC) | Control de Concurrencia Pesimista (PCC) |
|---|---|---|
| Suposición Principal | Conflictos poco frecuentes | Conflictos frecuentes |
| Manejo de Conflictos | Detecta conflictos al confirmar; aborta y reintenta si hay conflicto | Previene conflictos adquiriendo bloqueos antes de acceder |
| Bloqueos | No adquiere bloqueos preventivos (o los adquiere solo para validación final) | Adquiere bloqueos sobre recursos antes de usarlos |
| Cuando es adecuado | Cargas de trabajo con baja contención | Cargas de trabajo con alta contención |
| Rendimiento con alta contención | Puede sufrir debido a abortos y reintentos frecuentes | Puede sufrir debido a esperas por bloqueos |
| Complejidad de Implementación | Puede ser más complejo manejar versiones y la lógica de validación/reintento | La gestión de bloqueos (especialmente distribuidos) puede ser compleja |
| Ejemplos de Mecanismos | MVCC, Timestamp Ordering, CRDT, Snapshot Isolation | 2PL, Strict 2PL, Multiple Granularity Locking, DLM |
Preguntas Frecuentes sobre Control de Concurrencia
¿Por qué es importante el control de concurrencia en bases de datos distribuidas?
Es vital para asegurar la consistencia y la integridad de los datos cuando múltiples usuarios o procesos acceden y modifican los datos simultáneamente a través de diferentes nodos. Sin un control adecuado, las operaciones concurrentes podrían llevar a estados de datos incorrectos o inconsistentes.
¿Cuál es la principal diferencia entre OCC y PCC?
La principal diferencia radica en cuándo se abordan los posibles conflictos. OCC asume que son raros y los detecta y resuelve al final (validación/reintento), mientras que PCC asume que son probables y los previene activamente al principio mediante el uso de bloqueos.
¿Qué es MVCC y por qué se considera optimista?
MVCC (Multi-Version Concurrency Control) mantiene múltiples versiones de los datos, permitiendo que las transacciones de lectura procedan sin bloquear a las de escritura. Se considera optimista porque permite que las transacciones de lectura y escritura operen concurrentemente sin bloqueos mutuos *preventivos* sobre las versiones antiguas. Los conflictos potenciales se gestionan a través de la visibilidad de las versiones y, en algunos casos, la detección de conflictos al confirmar.
¿Qué es 2PL y por qué se considera pesimista?
2PL (Two-Phase Locking) es un protocolo que requiere que las transacciones adquieran todos los bloqueos necesarios antes de liberar cualquiera. Se considera pesimista porque se basa en la adquisición de bloqueos *antes* de acceder a los datos, asumiendo que es necesario prevenir conflictos potenciales al coste de bloquear a otras transacciones.
¿Pueden coexistir OCC y PCC en un mismo sistema?
Sí, es posible. Algunos sistemas de bases de datos híbridos o distribuidos pueden permitir configurar diferentes niveles de aislamiento o utilizar diferentes estrategias de control de concurrencia para distintas partes de la base de datos o para distintos tipos de transacciones, dependiendo de la carga de trabajo y los requisitos de rendimiento.
El control de concurrencia es un pilar fundamental en el diseño y la operación de bases de datos distribuidas robustas y confiables. La elección e implementación de los mecanismos adecuados son esenciales para lograr un equilibrio óptimo entre la consistencia de los datos, la disponibilidad y el rendimiento del sistema.
Si quieres conocer otros artículos parecidos a Control de Concurrencia en BDD Distribuidas puedes visitar la categoría Bases de datos.
Aprende mas sobre MySQL