
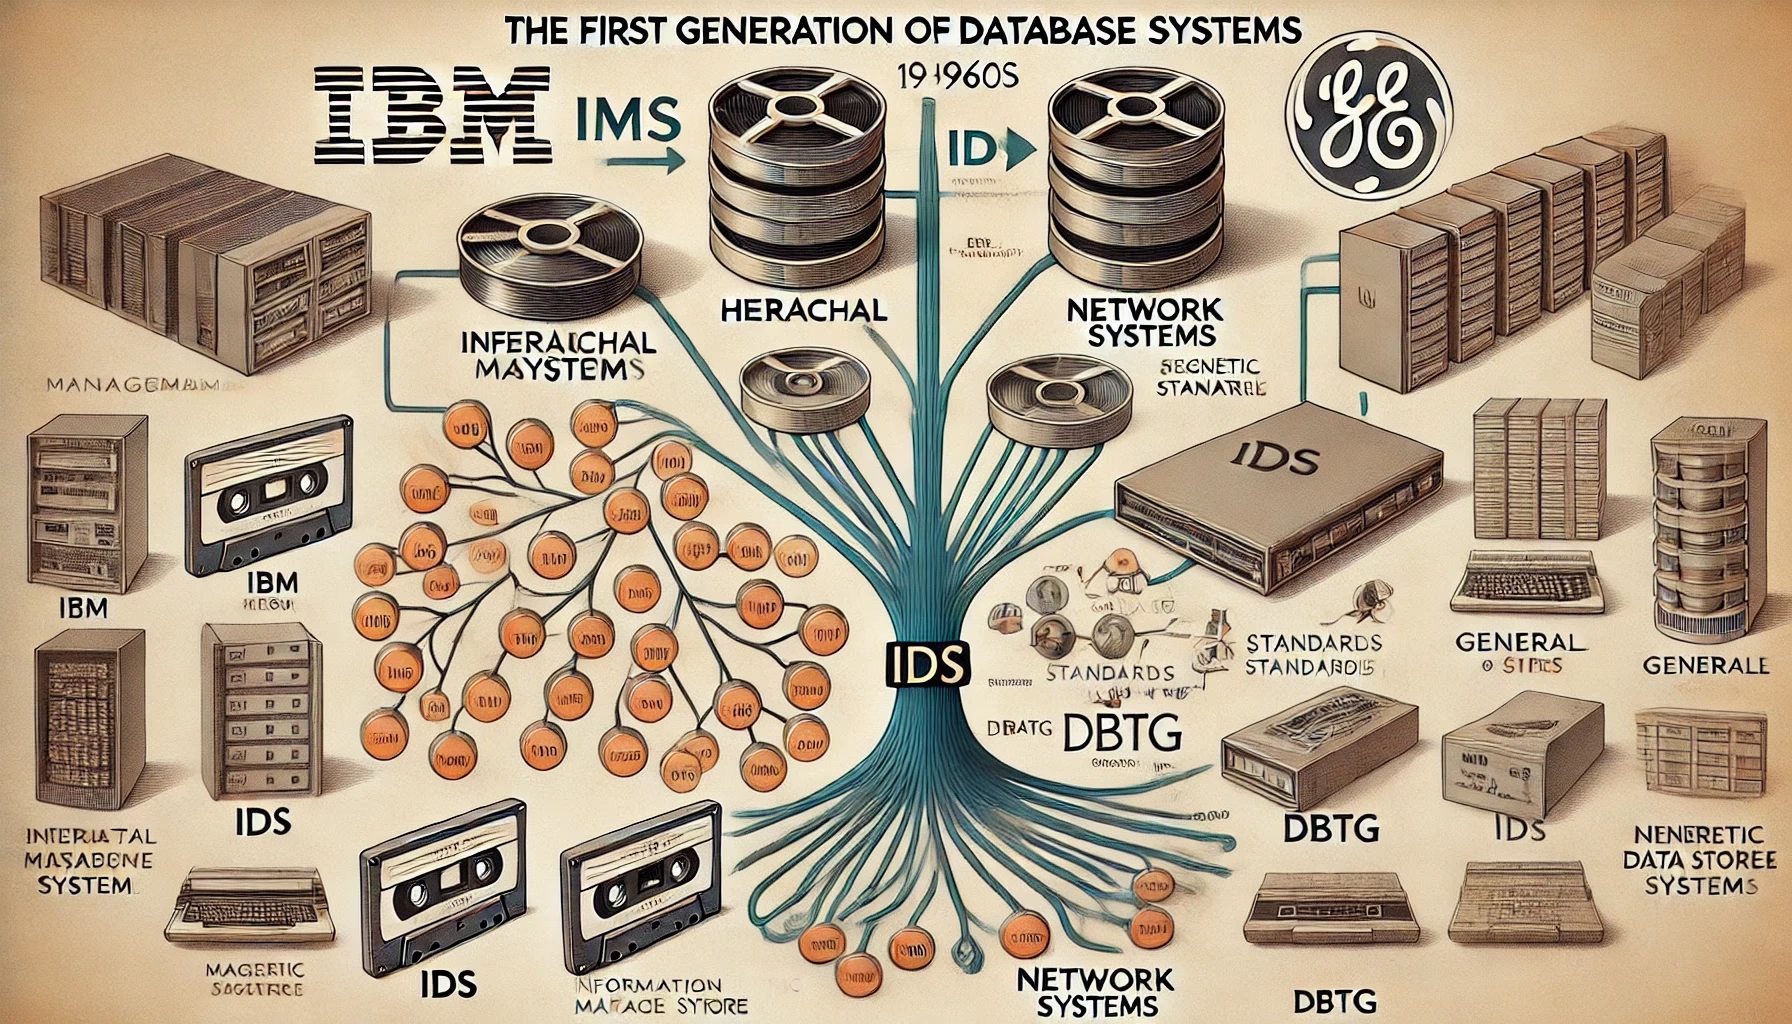
En el vasto universo de la gestión de datos, todo tuvo un comienzo. Antes de las sofisticadas bases de datos relacionales, NoSQL o en la nube que conocemos hoy, existieron modelos fundacionales que sentaron las bases de cómo organizar y acceder a la información de manera estructurada. Viajemos en el tiempo para descubrir cuál fue el primero de estos modelos y cómo funcionaba.
https://www.youtube.com/watch?v=ygUMI2Jhc2VzZGVkYXRv
La necesidad de almacenar y gestionar grandes volúmenes de información de manera eficiente no es algo nuevo. Ya en las décadas de 1950 y 1960, con el auge de las primeras computadoras mainframe, surgió la urgencia de sistemas más organizados que los simples archivos planos. Fue en este contexto histórico donde nació el modelo de base de datos más antiguo.

El Pionero: Bases de Datos Jerárquicas
El modelo de base de datos jerárquico es, sin lugar a dudas, el más antiguo de todos. Aunque su historia no está tan documentada como la de modelos posteriores, se sabe que surgió de la necesidad de gestionar información en los primeros sistemas de gestión de bases de datos (DBMS) para mainframes, influenciado por los sistemas de gestión de información (IMS) de la época (años 50 y 60).
A pesar de su antigüedad, este modelo no ha desaparecido por completo. Todavía hoy, algunas grandes organizaciones, especialmente bancos, compañías de seguros, departamentos gubernamentales y hospitales, siguen utilizándolo para sistemas heredados, como inventarios y contabilidad.
Estructura y Funcionamiento
El modelo jerárquico organiza los datos en una estructura de árbol. Piensa en un organigrama o en la estructura de archivos de un sistema operativo. Los datos se almacenan en registros, y cada registro tiene un conjunto de valores de campo asociados. Las instancias de un tipo de registro específico se agrupan como un "tipo de registro".
La conexión entre los diferentes tipos de registros se establece mediante relaciones padre-hijo. En esta estructura, una de las características más definitorias y limitantes es que cada registro "hijo" puede tener solo un registro "padre". Además, no son posibles las relaciones directas entre registros "hijo" del mismo nivel.
Esta estructura de árbol significa que, para acceder a un registro hijo, generalmente debes navegar a través de su padre. El punto de entrada a la base de datos es la raíz del árbol, el único registro sin padre.
Imaginemos, como ejemplo, una base de datos para un departamento universitario. Podríamos tener un registro padre para el Departamento, con registros hijo para Staff, Estudiantes, Cursos e Instalaciones. Sin embargo, si un miembro del personal trabaja para dos departamentos diferentes, el modelo jerárquico tendría dificultades. No podrías simplemente vincular ese empleado a dos padres (departamentos). La única solución sería crear dos instancias del registro del empleado, una bajo cada departamento. Esto, obviamente, lleva a la duplicación de datos y crea problemas de inconsistencia cuando la información necesita ser actualizada (tendrías que recordar actualizar ambas instancias).
La estructura es muy rígida, lo que facilita ciertas operaciones pero limita enormemente la flexibilidad. No se permiten vínculos entre capas en diferentes ramas del árbol, lo que simplifica la adición, actualización y eliminación de registros dentro de una rama, siempre y cuando sigas la jerarquía.
Ventajas del Modelo Jerárquico
A pesar de sus limitaciones vistas desde la perspectiva actual, el modelo jerárquico ofrecía ciertas ventajas en su momento:
- Diseño Sencillo: Para estructuras de datos inherentemente jerárquicas, el diseño era relativamente directo.
- Mantenimiento Económico: Comparado con sistemas más complejos, su mantenimiento podía ser más barato una vez implementado.
- Facilidad de Uso (en estructuras simples): Para consultas que seguían la estructura padre-hijo, el acceso era eficiente.
- Compartición y Seguridad de Datos: Al centralizar los datos, se podía aplicar seguridad y permitir la compartición (dentro de su estructura).
- Independencia de Datos: Se podía lograr cierto grado de independencia entre la aplicación y la estructura física de almacenamiento, aunque limitada por la rigidez de la jerarquía.
Limitaciones y Desventajas Clave
Las desventajas del modelo jerárquico son significativas y fueron las principales razones de la aparición de modelos más avanzados:
- Inflexibilidad: No puede representar fácilmente relaciones complejas o estructuras de datos que no se ajusten estrictamente a una jerarquía uno-a-muchos (un padre, muchos hijos). El ejemplo del estudiante con múltiples clases de diferentes "padres" (departamentos o profesores) es difícil de manejar.
- Dificultad para Implementar Relaciones Complejas: Las relaciones muchos-a-muchos son prácticamente imposibles de representar sin duplicación masiva de datos.
- Navegación Complicada: Excepto para el registro raíz, el acceso a cualquier dato debe pasar obligatoriamente por su padre. Esto hace que la navegación por el árbol sea compleja para consultas que no sigan la ruta jerárquica directa.
- Problema del Hijo con Múltiples Padres: Como se mencionó, un hijo no puede tener varios padres, lo que limita la representación de relaciones del mundo real.
- Alteración de Datos Difícil: Las reglas estrictas sobre las relaciones padre-hijo pueden dificultar la reestructuración o alteración de los datos una vez que la jerarquía está definida.
Debido a estas limitaciones, el modelo jerárquico no es adecuado para aplicaciones que requieren flexibilidad, relaciones complejas o consultas ad-hoc que no siguen una ruta jerárquica predefinida. Su uso actual se limita principalmente a sistemas heredados donde el costo de migración a un modelo más moderno es prohibitivo.
Evolución: Modelos Posteriores
Las limitaciones del modelo jerárquico llevaron a la búsqueda de estructuras más flexibles. El siguiente paso evolutivo significativo fue el Modelo de Red.
Modelo de Red
Desarrollado por Charles Bachman, el modelo de red es una extensión del modelo jerárquico. La principal diferencia y mejora es que permitía que un registro hijo tuviera múltiples padres. Esto se lograba utilizando la teoría de conjuntos para crear una estructura similar a un árbol pero donde los nodos (registros) podían tener varias conexiones entrantes (de padres). Esto permitía modelar relaciones muchos-a-muchos de una manera más eficiente que el modelo jerárquico.
Visualmente, en lugar de un solo árbol, el modelo de red se asemejaba más a un grafo, donde los nodos podían tener múltiples conexiones. Aunque era más flexible que el jerárquico y permitía modelar relaciones más complejas, todavía requería que el usuario (o programador) entendiera la estructura física de la base de datos para navegar por ella.
Modelo Relacional
La verdadera revolución llegó con el Modelo Relacional, propuesto por Edgar Codd en 1970. Su objetivo era permitir a los usuarios realizar consultas ad-hoc sobre los datos sin necesidad de conocer la estructura física de almacenamiento ni la navegación. Este modelo organiza los datos en tablas (o relaciones), donde cada tabla consta de filas (registros) y columnas (atributos).
Las relaciones entre las tablas se establecen mediante el uso de claves (claves primarias y claves foráneas). La clave de este modelo es su base matemática (teoría de conjuntos y lógica de predicados), que permitió el desarrollo de lenguajes de consulta declarativos como SQL (Structured Query Language). Con SQL, el usuario simplemente especifica qué datos necesita, y el sistema de base de datos (RDBMS) se encarga de cómo obtenerlos, liberando al usuario de la complejidad de la navegación.
La gran mayoría de las bases de datos utilizadas hoy en día (Oracle, SQL Server, MySQL, PostgreSQL, etc.) se basan en el modelo relacional.
Comparativa de Modelos Primerizos
Para entender mejor las diferencias clave entre los primeros modelos, veamos una tabla comparativa:
| Característica | Modelo Jerárquico | Modelo de Red | Modelo Relacional |
|---|---|---|---|
| Año/Década Origen | 1950s-1960s | 1960s | 1970s |
| Estructura de Datos | Árbol (Jerarquía) | Grafo (Red) | Tablas (Relaciones) |
| Relación Padre-Hijo | Un Padre, Muchos Hijos | Múltiples Padres, Muchos Hijos | No aplica directamente; relaciones vía claves |
| Relaciones Muchos-a-Muchos | Muy Difícil (requiere duplicación) | Posible (vía múltiples padres) | Fácil (vía tablas de enlace) |
| Navegación/Consulta | Jerárquica, requiere conocer la estructura | Basada en punteros/conjuntos, requiere conocer la estructura | Declarativa (SQL), no requiere conocer la estructura física |
| Flexibilidad | Baja | Media | Alta |
| Duplicación de Datos | Alta probabilidad en relaciones complejas | Menor que Jerárquico | Generalmente Baja (normalización) |
| Independencia de Datos | Limitada | Limitada | Alta |
Preguntas Frecuentes (FAQ)
Aquí respondemos algunas preguntas comunes sobre el modelo de base de datos más antiguo:
¿Por qué se usaba el modelo jerárquico si tenía tantas limitaciones?
En su época (años 50-60), era el primer intento de estructurar datos de manera organizada más allá de simples archivos. Para las estructuras de datos que inherentemente seguían una jerarquía (como la organización de un archivo en carpetas), funcionaba adecuadamente y era más eficiente que no tener ninguna estructura. Sus limitaciones se hicieron evidentes a medida que las necesidades de las aplicaciones se volvieron más complejas.
¿Todavía se utilizan las bases de datos jerárquicas hoy en día?
Sí, aunque no para nuevas aplicaciones. Existen sistemas heredados en grandes organizaciones (especialmente en finanzas, seguros y gobierno) que fueron construidos sobre DBMS jerárquicos (como IBM IMS) y que siguen operativos. La migración de estos sistemas es costosa y compleja, por lo que a menudo se mantienen, a veces con capas modernas encima para facilitar el acceso.
¿Cuál fue el modelo que reemplazó al jerárquico como predominante?
Aunque el modelo de red fue una mejora intermedia, el modelo que verdaderamente revolucionó y se convirtió en el estándar predominante fue el modelo relacional, gracias a su flexibilidad, independencia de datos y la potencia de lenguajes de consulta como SQL.
¿Es el modelo jerárquico eficiente para algún tipo de dato?
Es eficiente para datos que naturalmente se ajustan a una estricta estructura uno-a-muchos y donde las consultas de acceso siguen principalmente la ruta padre-hijo. Por ejemplo, la estructura de archivos en un disco duro es inherentemente jerárquica (carpetas dentro de carpetas).
Conclusión
El modelo de base de datos jerárquico representa el primer paso significativo en la evolución de la gestión estructurada de datos. Nacido de la necesidad de organizar información en los primeros sistemas mainframe, introdujo conceptos fundamentales como registros, campos y relaciones padre-hijo organizadas en una estructura de árbol. Si bien sus limitaciones, como la imposibilidad de manejar fácilmente relaciones muchos-a-muchos y la rigidez de su estructura, llevaron al desarrollo de modelos más flexibles como el de red y, finalmente, el relacional, su legado perdura en la forma en que pensamos sobre la organización de datos y en los sistemas heredados que aún operan hoy en día. Comprender el modelo jerárquico no solo responde a la pregunta de cuál fue el más antiguo, sino que también nos ayuda a apreciar la ingeniería y la evolución que han llevado a los potentes sistemas de bases de datos que utilizamos en la actualidad.
Si quieres conocer otros artículos parecidos a El Modelo de Base de Datos Más Antiguo puedes visitar la categoría Bases de datos.

Aprende mas sobre MySQL