
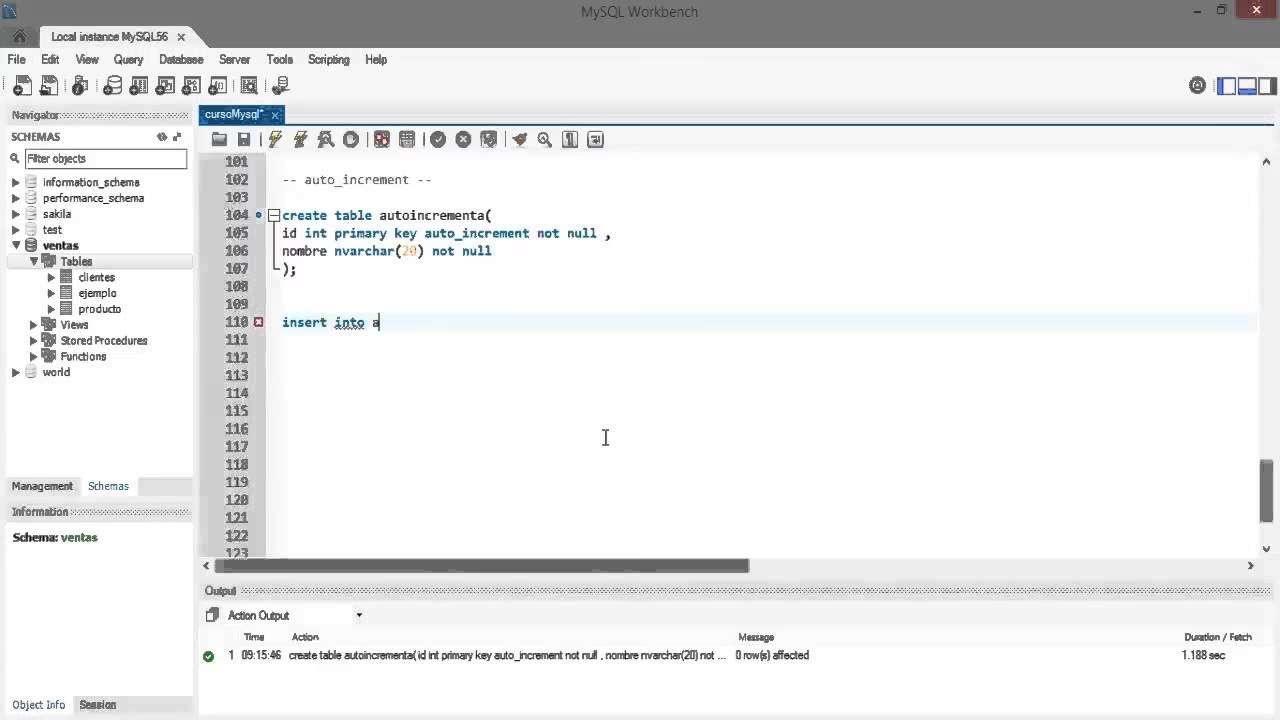
En el mundo del desarrollo de bases de datos, a menudo nos encontramos trabajando con campos que se generan automáticamente. Uno de los más comunes es el campo `AUTO_INCREMENT` en MySQL, que asigna un identificador único y secuencial a cada nueva fila que se inserta. Este valor es invaluable para identificar registros de forma inequívoca.

La necesidad de conocer este ID generado es frecuente, especialmente cuando se insertan datos relacionados en otras tablas. Sin embargo, surge una pregunta interesante y a veces confusa: ¿Es posible obtener el valor de `AUTO_INCREMENT` *antes* de que la inserción principal se complete? Y si es así, ¿cómo?
Aunque la forma más común y recomendada es obtener el ID *después* de la inserción, existe un método que algunas personas consideran para intentar obtenerlo *antes*. A continuación, exploraremos este enfoque, por qué generalmente no es la mejor idea, y cuál es la práctica estándar y más eficiente.
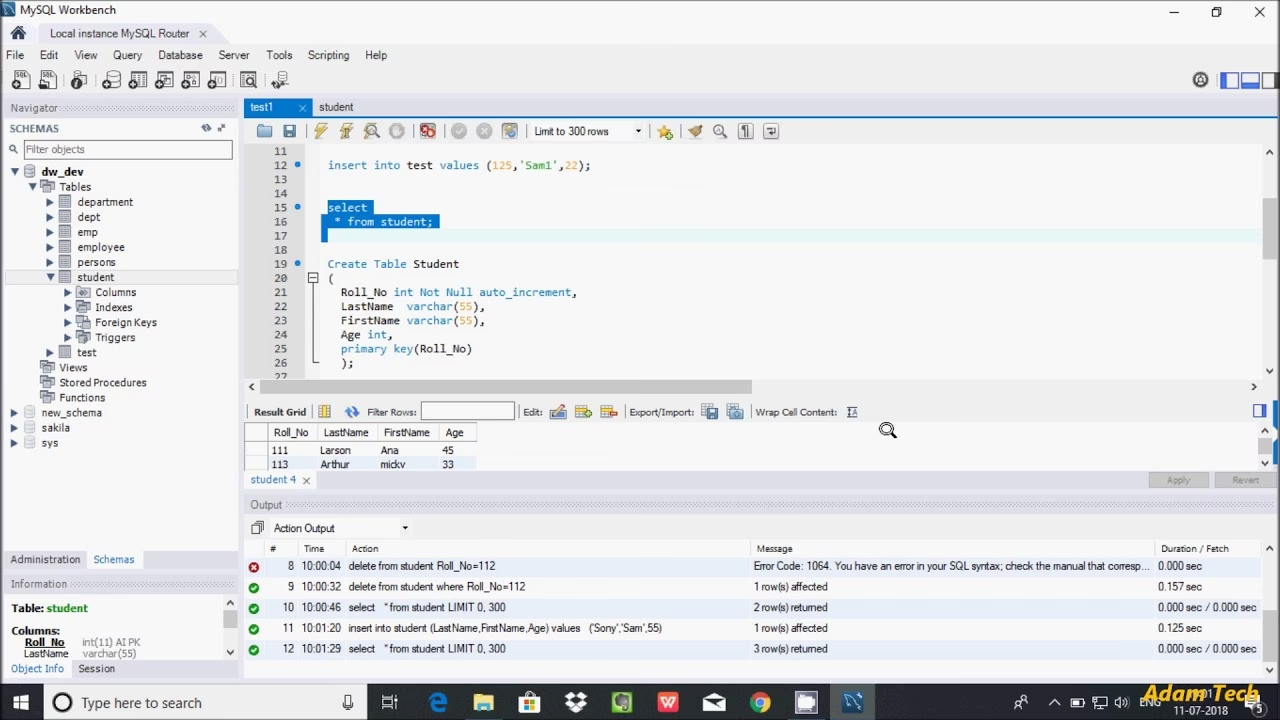
El Desafío: Conocer el ID por Adelantado
Imagina que tienes una tabla `ordenes` con un campo `id_orden` que es `AUTO_INCREMENT`. Luego tienes una tabla `detalles_orden` que necesita referenciar el `id_orden`. Idealmente, querrías insertar la orden principal y luego, con el ID generado, insertar los detalles relacionados. El problema (o la percepción del problema) surge si necesitas realizar alguna acción o preparar datos *antes* de la inserción final de la orden, basándote en cuál será ese ID.
Un Método Poco Convencional (y sus Pasos)
Existe un enfoque, aunque altamente no recomendable para la mayoría de los casos de uso en producción, que intenta "reservar" el próximo ID de `AUTO_INCREMENT`. Este método implica una serie de pasos:
- Paso 1: Insertar una fila vacía o mínima. Se inserta una fila en la tabla objetivo, con la menor cantidad de datos posible, o incluso con valores por defecto si la estructura lo permite. El objetivo es forzar a MySQL a generar el siguiente valor de `AUTO_INCREMENT`.
- Paso 2: Obtener el valor de `AUTO_INCREMENT` generado. Inmediatamente después de la inserción de la fila "temporal", se consulta la base de datos para obtener el ID que MySQL asignó a esa fila.
- Paso 3: Eliminar la fila temporal. Una vez que se conoce el ID, la fila que se insertó en el Paso 1 se elimina de la tabla.
- Paso 4: Insertar la fila real usando el valor obtenido. Finalmente, cuando los datos completos están listos, se inserta la fila definitiva utilizando el ID que se obtuvo en el Paso 2. Esto a menudo implica desactivar temporalmente la propiedad `AUTO_INCREMENT` para esa inserción específica o especificar el ID manualmente si la columna lo permite y no hay otras restricciones.
A primera vista, este proceso podría parecer que resuelve la necesidad de tener el ID *antes* de la inserción "real". Sin embargo, como veremos, introduce más problemas de los que resuelve.
¿Por Qué Este Método No es Recomendable?
Este enfoque, aunque técnicamente posible en algunos escenarios, tiene serias desventajas que lo hacen inapropiado para la mayoría de las aplicaciones, especialmente aquellas con concurrencia (varios usuarios o procesos accediendo a la base de datos al mismo tiempo):
- Ineficiencia de Rendimiento: En lugar de una sola operación de inserción, este método requiere al menos tres operaciones de base de datos (INSERT, SELECT, DELETE) y potencialmente una cuarta inserción (la final). Esto aumenta significativamente la carga en el servidor de base de datos y el tiempo de respuesta de la aplicación.
- Problemas de Concurrencia: Si múltiples usuarios intentan ejecutar este proceso simultáneamente, pueden surgir condiciones de carrera. Aunque `LAST_INSERT_ID()` es específico de la sesión, el acto de insertar y luego eliminar crea una ventana de tiempo donde el ID existe brevemente. Otros procesos podrían verse afectados, o la lógica podría complicarse enormemente para garantizar que cada proceso obtenga y use *su* ID reservado correctamente.
- Huecos en la Secuencia de IDs: El valor de `AUTO_INCREMENT` utilizado por la fila temporal *se consume*. Incluso si la fila se elimina, ese número ya no se reutilizará automáticamente para futuras inserciones estándar. Esto resulta en secuencias con huecos, lo que puede ser indeseable para algunos requisitos de negocio o auditoría.
- Complejidad Adicional: Implementar y mantener este flujo de trabajo es más complejo que la inserción directa. Se requiere manejo de errores adicional para asegurar que la eliminación se realice correctamente incluso si falla el paso de obtención del ID o la inserción final.
- Impacto en Transacciones: Integrar este método en transacciones puede ser complicado. Si la transacción falla después de la inserción temporal pero antes de la eliminación o la inserción final, podrías terminar con filas basura persistentes.
El Enfoque Estándar y Recomendado: Después de la Inserción
La forma canónica y eficiente de obtener el valor de `AUTO_INCREMENT` en MySQL es después de que la fila ha sido insertada. MySQL proporciona una función específica para esto: `LAST_INSERT_ID()`. Esta función devuelve el valor de `AUTO_INCREMENT` generado por la *última* sentencia `INSERT` ejecutada por la *conexión actual*. Esto es crucial: el ID es específico de la conexión, lo que lo hace seguro en entornos concurrentes.
El flujo de trabajo estándar sería:
- Preparar los datos para la inserción.
- Ejecutar la sentencia `INSERT`.
- Inmediatamente después, ejecutar `SELECT LAST_INSERT_ID();` en la misma conexión.
- Utilizar el ID obtenido para operaciones posteriores (como insertar filas relacionadas en otras tablas).
Este método es más rápido (una o dos operaciones en lugar de tres o cuatro), más simple, intrínsecamente seguro frente a problemas de concurrencia (porque `LAST_INSERT_ID()` es por sesión), y no deja huecos innecesarios en la secuencia de IDs.
Comparando los Métodos
| Característica | Método Temporal (Insertar/Eliminar) | Método Estándar (LAST_INSERT_ID()) |
|---|---|---|
| Rendimiento | Bajo (3+ operaciones por inserción) | Alto (1-2 operaciones por inserción) |
| Simplicidad | Alta (requiere múltiples pasos y manejo de errores) | Baja (una simple llamada después de INSERT) |
| Seguridad en Concurrencia | Baja (riesgo de condiciones de carrera/lógica compleja) | Alta (ID específico de la conexión) |
| Huecos en IDs | Sí, deja huecos por las filas eliminadas | No, los IDs se consumen secuencialmente por las inserciones exitosas |
| Uso de Transacciones | Complicado de integrar | Fácil y recomendado |
Implementación en PHP
Dado que la pregunta original menciona PHP, veamos cómo se implementan ambos enfoques.
Método Poco Convencional en PHP (Ejemplo - No Usar en Producción)
Este es solo para ilustrar la idea, no se recomienda su uso:
<?php
$conexion = new mysqli("servidor", "usuario", "contraseña", "basedatos");

// Paso 1: Insertar fila temporal
$sql_insert_temp = "INSERT INTO tu_tabla () VALUES ()";
$conexion->query($sql_insert_temp);

// Paso 2: Obtener el ID generado por la fila temporal
$id_generado = $conexion->insert_id;

if ($id_generado) {
 echo "ID temporal obtenido: " . $id_generado . "<br>";

 // Paso 3: Eliminar la fila temporal
 $sql_delete_temp = "DELETE FROM tu_tabla WHERE id_columna = " . $id_generado;
 $conexion->query($sql_delete_temp);
 echo "Fila temporal eliminada.<br>";

 // Paso 4: Preparar datos reales (ejemplo)
 $dato1 = "Valor1";
 $dato2 = "Valor2";

 // Insertar datos reales usando el ID obtenido (puede requerir desactivar AUTO_INCREMENT
 // o que la columna no sea solo AUTO_INCREMENT si ya hay otros índices)
 // ESTO ES COMPLICADO y depende de la estructura exacta de la tabla.
 // Un ejemplo simplificado asumiendo que puedes insertar el ID:
 $sql_insert_real = "INSERT INTO tu_tabla (id_columna, columna1, columna2) VALUES (" . $id_generado . ", '" . $dato1 . "', '" . $dato2 . "')";
 if ($conexion->query($sql_insert_real) === TRUE) {
 echo "Fila real insertada con ID: " . $id_generado . "<br>";
 } else {
 echo "Error al insertar fila real: " . $conexion->error . "<br>";
 }

} else {
 echo "Error al obtener ID temporal: " . $conexion->error . "<br>";
}

$conexion->close();
?>
Nótese la complejidad, el manejo de errores necesario y la advertencia sobre la inserción en el Paso 4, que puede ser problemática si la columna `AUTO_INCREMENT` es también clave primaria y no permite inserciones explícitas del ID fácilmente.
Método Estándar y Recomendado en PHP
Esta es la forma correcta y eficiente de manejarlo:
<?php
$conexion = new mysqli("servidor", "usuario", "contraseña", "basedatos");

// Preparar datos reales
$dato1 = "Valor1";
$dato2 = "Valor2";

// Ejecutar la inserción de la fila real
$sql_insert = "INSERT INTO tu_tabla (columna1, columna2) VALUES ('" . $dato1 . "', '" . $dato2 . "')";

if ($conexion->query($sql_insert) === TRUE) {
 // Obtener el ID generado por la inserción actual
 $id_generado = $conexion->insert_id;
 echo "Fila insertada exitosamente con ID: " . $id_generado . "<br>";

 // Ahora puedes usar $id_generado para insertar filas relacionadas en otras tablas
 // Ejemplo:
 // $sql_insert_detalle = "INSERT INTO detalles_tabla (id_principal, detalle) VALUES (" . $id_generado . ", 'Algun detalle')";
 // $conexion->query($sql_insert_detalle);

} else {
 echo "Error al insertar fila: " . $conexion->error . "<br>";
}

$conexion->close();
?>
Este código es mucho más limpio, directo y utiliza la funcionalidad de la base de datos de la manera prevista.
Preguntas Frecuentes (FAQ)
¿`LAST_INSERT_ID()` es realmente seguro si muchos usuarios insertan a la vez?
Sí. `LAST_INSERT_ID()` devuelve el valor de `AUTO_INCREMENT` más reciente *para la conexión actual*. Cada conexión de cliente tiene su propio `LAST_INSERT_ID()`. No hay riesgo de que obtengas el ID generado por la inserción de otro usuario.
¿El método temporal (insertar/eliminar) deja huecos en la secuencia de IDs?
Absolutamente. Cuando insertas una fila, MySQL asigna el siguiente valor de `AUTO_INCREMENT` disponible. Incluso si eliminas esa fila inmediatamente, ese número ya ha sido utilizado y el contador interno de `AUTO_INCREMENT` para la tabla avanza. Las futuras inserciones estándar comenzarán desde el siguiente número libre después del más alto utilizado hasta el momento (incluyendo los eliminados).
¿Hay alguna situación donde necesite el ID antes de la inserción final?
En la gran mayoría de los casos, la necesidad real es tener el ID disponible *después* de la inserción principal para vincular registros relacionados. Si la lógica de tu aplicación *realmente* requiere un identificador único *antes* de interactuar con la base de datos (por ejemplo, para usarlo en la lógica de negocio antes de persistir), podrías considerar generar un UUID (Universally Unique Identifier) en el lado de la aplicación en lugar de depender de `AUTO_INCREMENT`. Sin embargo, para referenciar registros dentro de la base de datos con `AUTO_INCREMENT`, el método estándar post-inserción es casi siempre el camino correcto.
¿Puedo usar transacciones con `LAST_INSERT_ID()`?
Sí, y es muy común y recomendado. Puedes iniciar una transacción, realizar la inserción, obtener el `LAST_INSERT_ID()`, usar ese ID para insertar en otras tablas dentro de la misma transacción, y finalmente, hacer un `COMMIT` (o `ROLLBACK` si algo falla). Esto asegura la atomicidad de tus operaciones.
Conclusión
Aunque existe un método que implica insertar una fila temporal, obtener su ID y luego eliminarla para intentar conocer el valor de `AUTO_INCREMENT` antes de la inserción final, esta técnica es ineficiente, compleja, propensa a problemas de concurrencia y deja secuencias con huecos. La práctica estándar y recomendada en MySQL es realizar la inserción principal y luego utilizar la función `LAST_INSERT_ID()` (o su equivalente en el lenguaje de programación que estés usando, como `$mysqli->insert_id` en PHP) para obtener el ID generado por esa inserción específica. Este enfoque es más simple, más rápido, más seguro y se integra perfectamente con el uso de transacciones, que son fundamentales para mantener la integridad de tus datos.
Si quieres conocer otros artículos parecidos a MySQL: ¿ID Antes de Insertar Datos? puedes visitar la categoría MySQL.
Aprende mas sobre MySQL