
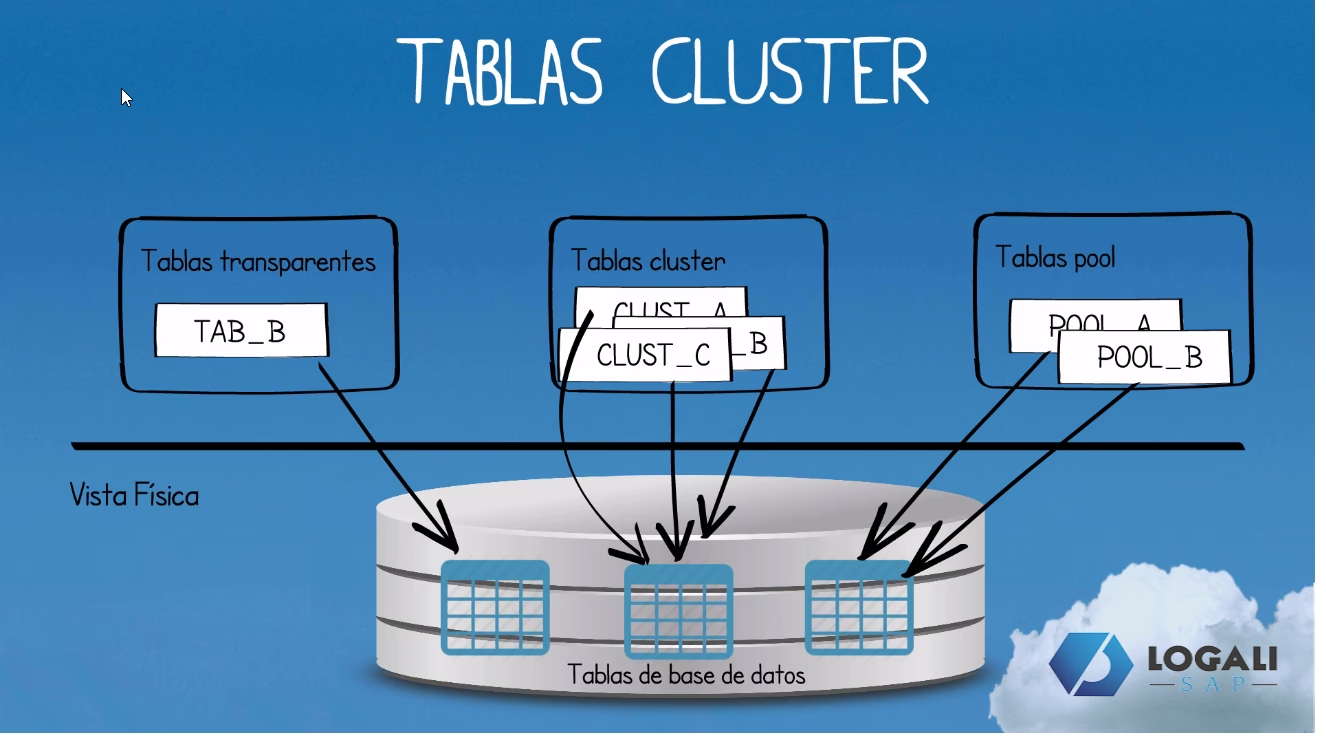
En el dinámico mundo de la gestión de datos, la capacidad de procesar grandes volúmenes de información de manera rápida y confiable es fundamental. Las bases de datos modernas enfrentan desafíos constantes en cuanto a carga de trabajo, crecimiento de datos y la necesidad imperante de estar siempre accesibles. Aquí es donde entran en juego los sistemas de clúster, una arquitectura que agrupa múltiples computadoras o servidores para trabajar conjuntamente como una única unidad lógica. Esta unión de recursos no solo potencia el rendimiento, sino que también añade capas cruciales de robustez y flexibilidad a la infraestructura de datos.
La construcción de un clúster de computadoras implica la interconexión de varios nodos (servidores) para compartir recursos y capacidades de procesamiento. Si bien la implementación técnica puede variar, el objetivo principal es superar las limitaciones de un único servidor. Al distribuir la carga de trabajo y replicar datos o servicios, un clúster puede manejar situaciones que desbordarían a un sistema individual, como picos de tráfico intensos o fallos de hardware. Esta capacidad de operación conjunta es lo que define a un sistema de clúster y lo convierte en una solución atractiva para entornos de bases de datos que demandan alto rendimiento y continuidad operativa.

Ventajas Clave de los Sistemas de Clúster para Bases de Datos
La adopción de sistemas de clúster en el ámbito de las bases de datos no es arbitraria; responde a necesidades muy específicas y críticas en la era digital. Las ventajas que ofrecen son directas y tienen un impacto significativo en la operación y crecimiento de cualquier aplicación o servicio que dependa de una base de datos robusta. Las principales ventajas se centran en el rendimiento, la escalabilidad, el soporte a alta carga de trabajo y, quizás la más crítica para muchas operaciones, la alta disponibilidad.
El alto rendimiento es una de las primeras y más evidentes ventajas. Al distribuir las consultas y operaciones entre varios nodos, un clúster puede procesar transacciones y ejecutar tareas analíticas mucho más rápido que un único servidor. Esto es especialmente importante en aplicaciones con alta concurrencia o en sistemas que requieren respuestas en tiempo real. La capacidad de paralelizar el trabajo a través de múltiples procesadores y recursos de memoria y disco permite manejar cargas de trabajo intensivas sin degradación significativa del rendimiento.
La escalabilidad es otra característica fundamental. Los sistemas de clúster están diseñados para crecer. A medida que la demanda de datos o la carga de trabajo aumenta, se pueden añadir nuevos nodos al clúster para incrementar su capacidad de procesamiento y almacenamiento. Esta expansión horizontal es a menudo más sencilla y económica que escalar verticalmente (mejorar un único servidor con hardware más potente), permitiendo una adaptación flexible a las necesidades cambiantes del negocio sin interrupciones mayores en el servicio.
El soporte a alta carga de trabajo es una consecuencia directa del alto rendimiento y la escalabilidad. Un clúster puede manejar un número significativamente mayor de usuarios concurrentes, transacciones por segundo o consultas complejas en comparación con un servidor individual. La carga se distribuye automáticamente entre los nodos disponibles, evitando cuellos de botella y asegurando que el sistema permanezca reactivo incluso bajo presión extrema. Esto es vital para aplicaciones web, sistemas de comercio electrónico o plataformas de análisis de datos a gran escala.
Finalmente, y de suma importancia para las operaciones críticas, la alta disponibilidad garantiza que la base de datos esté siempre accesible. En un clúster, si un nodo falla debido a un problema de hardware, software o red, los otros nodos pueden asumir su carga de trabajo de manera transparente. Esto minimiza o elimina el tiempo de inactividad (downtime), asegurando la continuidad del negocio y la satisfacción del usuario. La redundancia inherente en la arquitectura de clúster protege contra puntos únicos de fallo, haciendo que el sistema sea mucho más resiliente.
Diversas Clasificaciones de los Clústeres
Los sistemas de clúster, dada su versatilidad y las diversas formas en que pueden implementarse y utilizarse, se clasifican según distintos criterios. Estas clasificaciones ayudan a entender mejor la arquitectura y el propósito específico de un clúster. Las categorías principales suelen basarse en la disponibilidad, la aplicación principal, el hardware subyacente, el sistema operativo utilizado y la configuración de los nodos.
Comprender estas clasificaciones es útil al diseñar o seleccionar una infraestructura de clúster para una base de datos, ya que diferentes tipos de clústeres se adaptan mejor a distintos escenarios y requisitos.
Clasificación por Disponibilidad
Según la disponibilidad de los recursos de procesamiento, los clústeres pueden ser:
- Clústeres Dedicados: En esta configuración, los nodos del clúster están exclusivamente dedicados a ejecutar una única aplicación o carga de trabajo. En el contexto de bases de datos, esto significaría que el clúster completo está optimizado y utilizado únicamente para la operación de una base de datos específica. Los procesadores y otros recursos están funcionando al 100% en las tareas asignadas a esa base de datos. Esto permite un control muy fino sobre el rendimiento y asegura que no haya contención de recursos con otras aplicaciones, ideal para bases de datos de misión crítica con requisitos de rendimiento predecibles y altos.
- Clústeres No-Dedicados: Aquí, los procesadores y recursos de los nodos son compartidos por diferentes procesos o aplicaciones simultáneamente. Un nodo de clúster podría estar ejecutando la base de datos, pero también otras aplicaciones o servicios. La cantidad de recursos disponibles para la base de datos en un momento dado dependerá de la demanda de trabajo de los otros procesos. Esto puede ser más eficiente en términos de utilización de hardware general, pero puede introducir variabilidad en el rendimiento de la base de datos si no se gestiona adecuadamente la asignación de recursos. Son comunes en entornos donde se busca consolidar cargas de trabajo diversas.
Clasificación por Aplicación
Esta clasificación se centra en el propósito principal para el que se utiliza el clúster:
- Clústeres de Alto Desempeño (HPC - High-Performance Computing): Aunque el texto menciona el Cómputo Científico, el concepto se extiende a cualquier aplicación donde obtener el máximo rendimiento computacional es la prioridad. En bases de datos, esto se traduce en clústeres optimizados para procesar consultas complejas, análisis de datos a gran escala o cargas de trabajo transaccionales extremadamente altas en el menor tiempo posible. El enfoque está en minimizar el tiempo de procesamiento de CPU y optimizar el acceso a datos, a menudo utilizando sistemas de archivos distribuidos y redes de baja latencia.
- Clústeres de Alta Disponibilidad (HA - High Availability): Como se mencionó anteriormente, en este tipo de clúster lo fundamental es garantizar que el servicio de base de datos esté siempre disponible. La arquitectura está diseñada para detectar fallos en los nodos y conmutar automáticamente (failover) a un nodo redundante sin interrupción del servicio. Estos clústeres suelen incluir mecanismos de replicación de datos en tiempo real, monitoreo constante del estado de los nodos y sistemas de gestión de clúster que orquestan la recuperación ante fallos. Son esenciales para aplicaciones que no pueden permitirse ningún tiempo de inactividad, como servicios financieros, sistemas de salud o plataformas de telecomunicaciones.
Es importante notar que muchos clústeres de bases de datos buscan combinar ambas características, logrando tanto alto rendimiento como alta disponibilidad.
Clasificación por Hardware y Sistema Operativo
La clasificación puede hacerse también según las características físicas del hardware y el sistema operativo instalado en los nodos:
- Por Hardware: Se pueden construir clústeres a partir de diversos tipos de hardware, desde computadoras personales de escritorio (CoPs o PoPs) interconectadas, pasando por estaciones de trabajo más potentes (COWs), hasta servidores con múltiples procesadores simétricos (CLUMPs). La elección del hardware impacta directamente en el costo, la densidad de procesamiento y las capacidades de interconexión del clúster. Para bases de datos de producción crítica, suelen utilizarse servidores de gama alta (CLUMPs) o arquitecturas de hardware específicas optimizadas para I/O y procesamiento paralelo.
- Por Sistema Operativo: Los clústeres también se distinguen por el SO que ejecutan sus nodos. El texto menciona varios ejemplos históricos y contemporáneos:
- Clústeres-Beowulf: Basados en Linux. Son conocidos por ser una forma económica y flexible de construir clústeres HPC utilizando hardware commodity.
- Clústeres-NOW (Network Of Workstations): Que funcionaban a través de Solaris.
- Clústeres-NT: Basados en Windows NT.
- Clústeres-AIX: Utilizando el SO de IBM.
- Clústeres-VMS: Empleando el SO de Digital (posteriormente HP).
- Clústeres HP-UX y Microsoft Wolfpack: Otros ejemplos de implementaciones de clúster en entornos específicos de proveedores.
La elección del sistema operativo a menudo depende de la base de datos específica que se va a ejecutar (muchas bases de datos están optimizadas para ciertos SOs) y de la experiencia del equipo de administración. Linux y Windows Server son los SOs más comunes en clústeres de bases de datos hoy en día.
La combinación de hardware y SO define la plataforma base sobre la cual se construirá y gestionará el clúster de bases de datos.
Clasificación por Configuración
Finalmente, la configuración de los nodos a nivel de hardware y sistema operativo lleva a la distinción entre clústeres homogéneos y heterogéneos:
- Clústeres Homogéneos: En un clúster homogéneo, todos los nodos tienen arquitecturas de hardware similares (procesadores, memoria, almacenamiento) y ejecutan la misma versión del mismo sistema operativo. Esta configuración simplifica enormemente la administración, el mantenimiento y la gestión de software (incluida la base de datos), ya que todos los nodos se comportan de manera idéntica. La distribución de la carga de trabajo suele ser más sencilla y predecible. Es la configuración preferida cuando es posible, ya que reduce la complejidad operativa.
- Clústeres Heterogéneos: En un clúster heterogéneo, los nodos pueden tener arquitecturas de hardware diferentes y/o ejecutar sistemas operativos distintos. Por ejemplo, un clúster podría combinar servidores más antiguos con hardware más nuevo, o máquinas Linux con máquinas Windows. Esta configuración puede surgir por la necesidad de integrar infraestructura existente o por la adquisición gradual de hardware. Si bien ofrece flexibilidad y permite aprovechar recursos existentes, la gestión y el mantenimiento de un clúster heterogéneo son considerablemente más complejos. Requiere software de gestión de clúster más sofisticado y puede presentar desafíos en la distribución equitativa de la carga de trabajo y la compatibilidad del software de base de datos entre diferentes plataformas.
La elección entre una configuración homogénea o heterogénea depende de los recursos disponibles, los requisitos de flexibilidad y la capacidad del equipo para gestionar la complejidad.
Resumen de Clasificaciones
| Criterio de Clasificación | Tipos | Descripción Aplicada a Bases de Datos |
|---|---|---|
| Disponibilidad | Dedicado No-Dedicado | Recursos exclusivos para la BD vs. Recursos compartidos con otras apps. |
| Aplicación | Alto Desempeño Alta Disponibilidad | Optimizado para velocidad de procesamiento vs. Optimizado para continuidad operativa. |
| Hardware | CoPs, COWs, CLUMPs Otros | Basado en PCs, estaciones de trabajo, servidores multi-CPU, etc. |
| Sistema Operativo | Beowulf (Linux), NT (Windows), AIX, VMS, etc. | Depende del SO base de los nodos del clúster. |
| Configuración | Homogéneo Heterogéneo | Nodos idénticos en hardware y SO vs. Nodos con diferentes hardware y/o SOs. |
Preguntas Frecuentes sobre Clústeres de Bases de Datos
- ¿Por qué necesito un clúster para mi base de datos?
- Un clúster es necesario cuando un solo servidor no puede satisfacer los requisitos de rendimiento, escalabilidad o alta disponibilidad de tu aplicación. Permite manejar mayores cargas de trabajo, crecer según la demanda y asegurar que tu base de datos esté siempre accesible, incluso si falla un servidor.
- ¿Cuál es la diferencia principal entre un clúster de alto desempeño y uno de alta disponibilidad?
- Un clúster de alto desempeño se centra en maximizar la velocidad de procesamiento de datos y consultas. Un clúster de alta disponibilidad se enfoca en minimizar el tiempo de inactividad y garantizar la continuidad del servicio mediante redundancia y mecanismos de conmutación por error.
- ¿Son los clústeres heterogéneos más difíciles de gestionar?
- Generalmente sí. La diversidad de hardware y sistemas operativos en un clúster heterogéneo introduce complejidad en la administración, el mantenimiento, la monitorización y la compatibilidad del software de base de datos en comparación con un clúster homogéneo donde todos los nodos son idénticos.
- ¿Puede un clúster de bases de datos combinar alto desempeño y alta disponibilidad?
- Sí, de hecho, muchas implementaciones modernas de clústeres de bases de datos buscan ofrecer ambas características. Utilizan arquitecturas que permiten la distribución de carga para mejorar el rendimiento y mecanismos de replicación y failover para asegurar la alta disponibilidad.
En conclusión, los sistemas de clúster representan una solución poderosa y flexible para los desafíos que enfrentan las bases de datos en la actualidad. Al agrupar recursos, ofrecen mejoras significativas en rendimiento, escalabilidad y, crucialmente, alta disponibilidad. Comprender las diferentes formas en que se clasifican estos sistemas es fundamental para seleccionar e implementar la arquitectura de clúster más adecuada a las necesidades específicas de una base de datos, asegurando así una infraestructura robusta y capaz de soportar el crecimiento y las demandas futuras.
Si quieres conocer otros artículos parecidos a Clústeres: Potencia y Disponibilidad en BD puedes visitar la categoría Tecnología.

Aprende mas sobre MySQL