
En la era digital, la cantidad de datos que generamos y recopilamos crece a un ritmo exponencial. Este volumen masivo, conocido como Big Data, presenta tanto desafíos como oportunidades. No se trata solo de la cantidad, sino también de la variedad y velocidad con la que se producen estos datos, que a menudo no encajan en las estructuras tradicionales de las bases de datos relacionales. Para aprovechar el valor oculto en estos inmensos conjuntos de información, se requieren enfoques, arquitecturas y herramientas especializadas que permitan su gestión, procesamiento y análisis eficiente. Este artículo explora los fundamentos de cómo se maneja el Big Data para convertirlo en inteligencia de negocio.

- La Arquitectura del Big Data: Un Plano Fundamental
- Análisis del Big Data: Desbloqueando el Valor
- Hadoop: El Motor Distribuido para el Big Data
- Almacenamiento para Big Data: Data Lakes, Data Warehouses y NoSQL
- Bases de Datos en Memoria: Velocidad y Eficiencia
- Preguntas Frecuentes sobre el Manejo del Big Data
- Conclusión
La Arquitectura del Big Data: Un Plano Fundamental
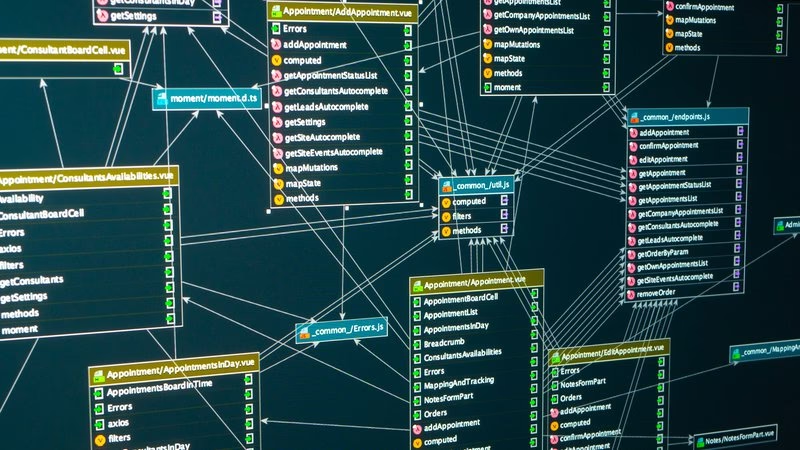
Al igual que en la construcción de edificios, la arquitectura del Big Data proporciona un plano para la estructura fundamental de cómo las empresas gestionarán y analizarán sus datos. Esta arquitectura traza los procesos necesarios para manejar el Big Data a lo largo de su recorrido a través de cuatro 'capas' básicas:
El viaje comienza en la capa de fuentes de datos, donde se origina la información en diversas formas y formatos. Luego, pasa a la capa de almacenamiento de datos, donde se guarda de manera eficiente y escalable. La tercera capa es la de análisis de Big Data, donde se aplican técnicas y algoritmos para extraer patrones y conocimientos. Finalmente, la capa de consumo es donde los resultados analizados se presentan como inteligencia de negocio, informes o visualizaciones para la toma de decisiones.
Tener una arquitectura bien definida es crucial para asegurar que los datos fluyan correctamente, se almacenen de forma adecuada y estén listos para ser analizados, maximizando así su potencial.
Análisis del Big Data: Desbloqueando el Valor
El análisis del Big Data es el proceso que permite obtener visualizaciones significativas de los datos mediante el uso de modelado de datos y algoritmos específicos adaptados a las características del Big Data. Este proceso va más allá de la simple generación de informes; busca descubrir patrones complejos, tendencias ocultas y correlaciones que no serían evidentes con métodos tradicionales.
Un estudio y encuesta en profundidad de la MIT Sloan School of Management, que consultó a más de 2,000 líderes empresariales sobre la experiencia de sus empresas con el análisis de Big Data, encontró resultados reveladores. No fue sorprendente que aquellos que estaban comprometidos y apoyaban el desarrollo de sus estrategias de gestión de Big Data lograron los resultados empresariales más medibles y beneficiosos. Esto subraya la importancia no solo de recopilar datos, sino de invertir activamente en las capacidades de análisis para obtener una ventaja competitiva.
Hadoop: El Motor Distribuido para el Big Data
Para entender cómo herramientas como Hadoop abordan el desafío del Big Data, consideremos una analogía. Imagina 10 monedas de diez centavos en una caja grande mezcladas con 100 monedas de cinco centavos. Ahora imagina 10 cajas más pequeñas, una al lado de la otra, cada una con 10 monedas de cinco centavos y solo una moneda de diez centavos. ¿En qué escenario será más fácil encontrar las monedas de diez centavos? En el segundo, donde el problema se ha dividido en partes más pequeñas y manejables.
Hadoop básicamente funciona sobre este principio. Es un framework de código abierto diseñado para gestionar el procesamiento distribuido del Big Data a través de una red de muchas computadoras conectadas. En lugar de usar una única computadora grande para almacenar y procesar todos los datos (como la caja grande), Hadoop agrupa múltiples computadoras en una red casi infinitamente escalable y analiza los datos en paralelo (como las cajas pequeñas). Este proceso típicamente utiliza un modelo de programación llamado MapReduce, que coordina el procesamiento del Big Data orquestando las computadoras distribuidas. Esto permite procesar volúmenes de datos que serían imposibles para una sola máquina, y hacerlo de manera mucho más rápida.
Almacenamiento para Big Data: Data Lakes, Data Warehouses y NoSQL
Las bases de datos tradicionales basadas en SQL, con su estructura de hoja de cálculo, están diseñadas para almacenar datos estructurados (datos que encajan bien en tablas con filas y columnas predefinidas). Sin embargo, el Big Data a menudo incluye datos no estructurados y semiestructurados (como texto libre, imágenes, audio, datos de sensores, registros web) que requieren paradigmas únicos de almacenamiento y procesamiento, ya que no se prestan fácilmente a ser indexados y categorizados en un esquema fijo.
Para gestionar estos conjuntos de datos no tradicionales, han surgido diferentes tipos de repositorios:
- Data Lake: Es un vasto lago de datos brutos. Almacena datos en su formato nativo (estructurado, semiestructurado o no estructurado) sin un esquema predefinido al momento de la ingesta (schema-on-read). El propósito es tener todos los datos disponibles para análisis futuros, exploraciones y descubrimientos, incluso si aún no se sabe cómo se usarán.
- Data Warehouse: Es un repositorio para datos que ya han sido procesados, limpiados y transformados para un propósito específico, generalmente informes de inteligencia de negocio y análisis estructurados. Los datos en un Data Warehouse están altamente estructurados y organizados (schema-on-write).
- Bases de Datos NoSQL: Estas bases de datos proporcionan un esquema flexible o inexistente que puede modificarse fácilmente para adaptarse a la naturaleza cambiante o variada de los datos a procesar. Son ideales para almacenar datos no estructurados o semiestructurados y ofrecen alta escalabilidad y rendimiento para ciertas cargas de trabajo. Existen varios tipos, como bases de datos de documentos, clave-valor, de columnas anchas o de grafos.
Cada uno de estos sistemas de almacenamiento tiene sus fortalezas y debilidades. Muchas empresas utilizan una combinación de estos diferentes repositorios de datos para satisfacer mejor sus diversas necesidades de gestión de datos.
Comparativa de Repositorios de Datos para Big Data
| Característica | Data Lake | Data Warehouse | Base de Datos NoSQL |
|---|---|---|---|
| Propósito Principal | Exploración, descubrimiento, análisis futuros sobre datos brutos. | Informes estructurados y Business Intelligence sobre datos limpios. | Almacenamiento escalable de datos no estructurados/semiestructurados con flexibilidad. |
| Tipo de Datos | Brutos, estructurados, semiestructurados, no estructurados. | Estructurados, limpios, transformados. | No estructurados, semiestructurados, a veces estructurados; flexible. |
| Esquema | Schema-on-read (el esquema se aplica al consultar). | Schema-on-write (el esquema se define al cargar). | Flexible o sin esquema fijo. |
| Usuarios Típicos | Científicos de datos, analistas avanzados. | Analistas de negocio, usuarios de BI. | Desarrolladores, arquitectos de datos. |
| Coste | Generalmente más bajo (almacenamiento más barato). | Generalmente más alto (requiere procesamiento previo y estructura). | Varía; a menudo más escalable horizontalmente. |
Bases de Datos en Memoria: Velocidad y Eficiencia
Las bases de datos tradicionales basadas en disco se desarrollaron pensando en tecnologías de bases de datos relacionales y SQL. Si bien pueden manejar grandes volúmenes de datos estructurados, simplemente no están diseñadas para almacenar y procesar de manera óptima datos no estructurados a la velocidad requerida por muchas aplicaciones de Big Data y análisis en tiempo real.
Con las bases de datos en memoria (in-memory databases), el procesamiento y el análisis tienen lugar completamente en la memoria RAM del sistema, a diferencia de tener que recuperar los datos de un sistema basado en disco. El acceso a la RAM es significativamente más rápido que el acceso al disco, lo que reduce drásticamente la latencia y acelera las operaciones de lectura y escritura.
Además, las bases de datos en memoria también se construyen sobre arquitecturas distribuidas. Esto significa que pueden lograr velocidades mucho mayores utilizando procesamiento paralelo a través de múltiples nodos, a diferencia de los modelos de bases de datos basados en disco de nodo único. Esta combinación de procesamiento en RAM y arquitectura distribuida las hace especialmente adecuadas para cargas de trabajo de análisis de alta velocidad y aplicaciones que requieren respuestas casi instantáneas.
Preguntas Frecuentes sobre el Manejo del Big Data
Aquí respondemos algunas preguntas comunes relacionadas con la gestión y el análisis del Big Data:
¿Por qué no se puede usar una base de datos tradicional para todo Big Data?
Las bases de datos tradicionales (SQL, relacionales) están optimizadas para datos estructurados y requieren un esquema fijo. El Big Data a menudo es no estructurado o semiestructurado, y su volumen y velocidad superan las capacidades de escalabilidad y rendimiento de los sistemas tradicionales.
¿Cuál es la diferencia principal entre un Data Lake y un Data Warehouse?
La diferencia clave radica en el propósito y la estructura de los datos. Un Data Lake almacena datos brutos en su formato original para exploración (schema-on-read), mientras que un Data Warehouse almacena datos procesados y estructurados para informes específicos (schema-on-write).
¿Qué hace a Hadoop especial para Big Data?
Hadoop es especial por su capacidad para almacenar y procesar grandes volúmenes de datos de forma distribuida y paralela a través de clusters de computadoras. Esto permite escalar horizontalmente y manejar cargas de trabajo que serían imposibles para una sola máquina.
¿Cuándo usaría una base de datos NoSQL?
Usaría una base de datos NoSQL cuando necesite almacenar datos no estructurados o semiestructurados, cuando la estructura de los datos cambie con frecuencia, o cuando requiera una alta escalabilidad y rendimiento para aplicaciones distribuidas, como en tiempo real o basadas en la web.
¿Qué ventaja tienen las bases de datos en memoria?
La principal ventaja es la velocidad. Al procesar datos directamente en la RAM en lugar del disco, las bases de datos en memoria ofrecen un rendimiento mucho mayor para análisis rápidos y aplicaciones que requieren baja latencia, especialmente cuando se combinan con arquitecturas distribuidas.
Conclusión
Manejar y extraer valor del Big Data es un desafío complejo que requiere un conjunto de herramientas y enfoques especializados. Desde la definición de una arquitectura sólida que guíe el flujo de datos, pasando por el uso de motores de procesamiento distribuido como Hadoop, hasta la elección adecuada de soluciones de almacenamiento como Data Lake, Data Warehouse o bases de datos NoSQL, y la adopción de tecnologías de alto rendimiento como las bases de datos en memoria; cada componente juega un papel vital. Comprender estas tecnologías y cómo interactúan es fundamental para cualquier organización que busque convertir el vasto océano de datos en inteligencia accionable y estratégica.
Si quieres conocer otros artículos parecidos a Explorando el Big Data: Arquitectura y Análisis puedes visitar la categoría Tecnología.
Aprende mas sobre MySQL