
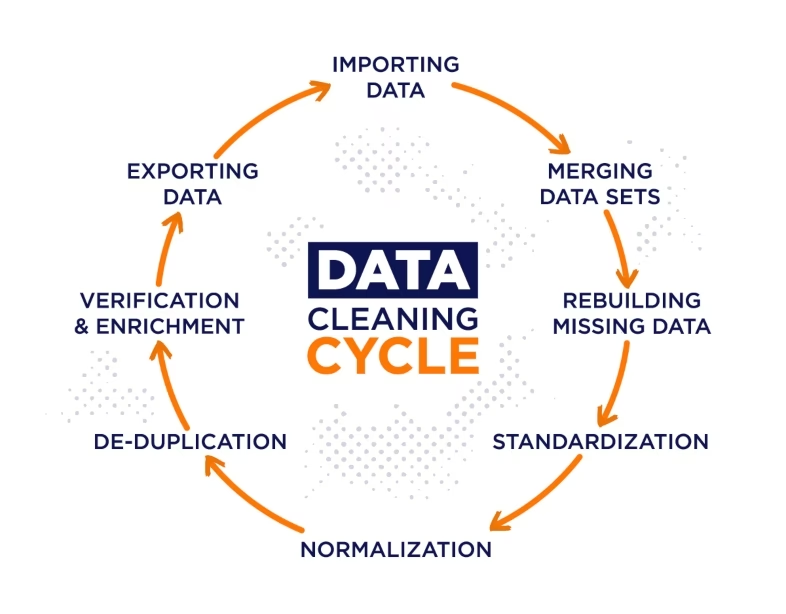
En la era del Big Data, la información se ha convertido en el activo más valioso para cualquier organización. Sin embargo, la mera acumulación de datos no garantiza el éxito. ¿Qué tan seguro estás de la calidad de la información en la que basas tus decisiones? Si no has aplicado Data Cleansing recientemente, es probable que estés navegando con un mapa incompleto o incorrecto.

La limpieza de datos, o Data Cleansing, es un proceso fundamental que permite transformar conjuntos de datos masivos y potencialmente caóticos en fuentes de información confiables y precisas. En este artículo, exploraremos en profundidad qué implica este proceso, por qué su implementación es más importante que nunca, los beneficios que aporta y cómo llevarlo a cabo de manera efectiva, incluyendo las herramientas que pueden facilitar esta tarea crucial.
- ¿Qué es la Limpieza de Datos (Data Cleansing)?
- ¿Por qué es Crucial la Limpieza de Datos?
- Beneficios Tangibles del Data Cleansing
- El Proceso Paso a Paso para Limpiar Datos
- 1. Auditoría de Datos
- 2. Definición de un Plan o Workflow
- 3. Eliminación de Datos Duplicados o Irrelevantes
- 4. Corrección de Errores Estructurales y de Formato
- 5. Manejo de Valores Faltantes
- 6. Filtrado de Valores Atípicos (Outliers)
- 7. Validación y Control de Calidad (QA)
- 8. Documentación y Mantenimiento
- Herramientas Clave para la Limpieza de Datos
- Desafíos Comunes en el Data Cleansing
- Preguntas Frecuentes sobre Limpieza de Datos
¿Qué es la Limpieza de Datos (Data Cleansing)?
El Data Cleansing, también conocido como limpieza de datos o data scrubbing, se refiere al acto de identificar y corregir o eliminar datos erróneos, incompletos, duplicados o formateados incorrectamente dentro de una base de datos o un conjunto de datos. En el contexto del Big Data, donde la información proviene de múltiples fuentes y en diversos formatos, la probabilidad de encontrar inconsistencias es muy alta.
Cuando se combinan datos de diferentes sistemas (CRM, ventas, marketing, etc.), es común que surjan registros duplicados, errores tipográficos, formatos inconsistentes (por ejemplo, fechas o direcciones escritas de diferentes maneras), valores faltantes o información desactualizada. El proceso de Data Cleansing aborda estas problemáticas para asegurar que los datos sean precisos, consistentes, completos y relevantes.
Imagina que estás analizando datos de clientes para lanzar una campaña de marketing dirigida. Si tu base de datos contiene clientes duplicados con direcciones diferentes, o contactos con información de correo electrónico o teléfono incorrecta, tu campaña no solo será ineficiente (enviar el mismo mensaje varias veces a la misma persona, o enviarlo a contactos inválidos), sino que también podría dañar la percepción que el cliente tiene de tu marca. Aquí radica la importancia del Data Cleansing: garantizar que los datos reflejen la realidad de manera fiel.
Como señala Mario Hernández, profesor del curso online Fundamentos de base de datos, los datos son un insumo fundamental para la gran mayoría de empresas, permitiéndoles operar de manera eficiente y tomar decisiones informadas. Sin embargo, esto solo es posible si los datos son confiables. Las bases de datos son herramientas tecnológicas para almacenar datos de manera confiable, pero la confiabilidad de los datos en sí mismos depende de procesos como el Data Cleansing.
¿Por qué es Crucial la Limpieza de Datos?
La importancia del Data Cleansing no puede subestimarse, especialmente en un entorno donde las decisiones empresariales se basan cada vez más en el análisis de datos. Datos 'sucios' o de baja calidad pueden llevar a conclusiones erróneas, estrategias mal dirigidas y, en última instancia, pérdidas económicas o de oportunidades.
Un análisis de datos eficiente, preciso y efectivo requiere datos limpios. Si el Big Data que estás analizando está desorganizado, incompleto o contiene errores, cualquier algoritmo o modelo que apliques producirá resultados poco confiables. Esto es crítico para áreas como la inteligencia de negocio, el machine learning o la analítica predictiva.
Considera el ejemplo de una empresa que desarrolla una aplicación basada en datos de sus clientes, similar a lo que Domino's Pizza hizo con su software AnyWare. Si los datos de los clientes utilizados para entender sus hábitos y preferencias no están limpios y actualizados, las características o mejoras implementadas en la aplicación podrían no satisfacer las necesidades reales de los usuarios. Esto podría resultar en una aplicación que no cumpla su objetivo, afectando la satisfacción del cliente y la competitividad de la empresa.
La calidad de los datos impacta directamente en la capacidad de una organización para identificar tendencias emergentes, comprender las necesidades cambiantes de los clientes y tomar decisiones estratégicas acertadas. El Data Cleansing es el primer paso para asegurar que los datos proporcionen una base sólida para la toma de decisiones.
Beneficios Tangibles del Data Cleansing
Implementar un proceso de limpieza de datos trae consigo una serie de beneficios operativos y estratégicos que pueden mejorar significativamente el rendimiento de una organización:
- Eliminación de Errores e Inconsistencias: El beneficio más obvio es la corrección de datos incorrectos, inconsistentes o incompletos que surgen al integrar múltiples fuentes de datos. Esto proporciona una visión unificada y precisa de la información.
- Mejora de la Eficiencia Operacional: Con datos limpios y bien organizados, los equipos pueden acceder rápidamente a la información que necesitan, reduciendo el tiempo dedicado a buscar, corregir o interpretar datos confusos.
- Decisiones Más Precisas y Confiables: Al basar las decisiones en datos de alta calidad, las empresas pueden tener mayor confianza en sus estrategias, ya sea para identificar oportunidades de mercado, optimizar procesos o mejorar la experiencia del cliente.
- Mayor Satisfacción del Cliente: Datos precisos permiten una comunicación más efectiva y personalizada con los clientes, evitan errores en pedidos o entregas, y mejoran la calidad del servicio, lo que se traduce en clientes más felices y leales.
- Aumento de la Productividad Interna: Los empleados se frustran menos al trabajar con datos confiables. Esto libera tiempo y energía que pueden dedicarse a tareas de mayor valor estratégico.
- Mejor Comprensión de los Datos: El proceso de limpieza a menudo revela la procedencia de los datos y cómo se supone que deben usarse, mejorando la gobernanza y el entendimiento general de los activos de datos.
- Optimización de las Herramientas de Análisis: Muchos algoritmos y herramientas de análisis de datos funcionan mejor o solo funcionan correctamente con datos limpios. La limpieza es un pre-requisito para el éxito de iniciativas de analítica avanzada.
En resumen, el Data Cleansing no es solo una tarea técnica, es una inversión estratégica que impulsa la eficiencia, la productividad y la capacidad de una empresa para competir en el mercado actual.
El Proceso Paso a Paso para Limpiar Datos
Aunque el proceso exacto de Data Cleansing puede variar según el tipo y la complejidad de los datos, existen pasos básicos que constituyen un marco sólido para abordarlo. Aquí presentamos una guía práctica:
1. Auditoría de Datos
Antes de limpiar, debes entender qué está sucio. La auditoría de datos implica examinar los datos existentes para identificar anomalías, inconsistencias y errores. Esto puede hacerse usando métodos estadísticos para detectar valores atípicos, analizando la distribución de los datos, buscando valores faltantes o revisando formatos. El objetivo es obtener una visión clara del estado actual de la calidad de los datos.
2. Definición de un Plan o Workflow
Una vez que se identifican los problemas, es crucial definir cómo se corregirán. Esto implica crear un flujo de trabajo (workflow) que detalle las operaciones necesarias para limpiar los datos. El workflow debe basarse en la comprensión de las causas subyacentes de los errores (por ejemplo, errores de entrada de datos, problemas de integración) y las reglas de negocio o de formato que los datos deben cumplir.
3. Eliminación de Datos Duplicados o Irrelevantes
Los duplicados son muy comunes, especialmente al consolidar datos de múltiples fuentes. Identificar y eliminar registros repetidos es un paso esencial. También se deben eliminar datos que son irrelevantes para el análisis o el objetivo específico que se persigue (por ejemplo, información de clientes de otras regiones si solo se analiza un mercado local).
4. Corrección de Errores Estructurales y de Formato
Estos errores incluyen inconsistencias en la nomenclatura, errores tipográficos, uso inconsistente de mayúsculas/minúsculas, o formatos incorrectos (ej. 'Calle' vs 'Clle', 'USA' vs 'Estados Unidos'). Corregir estos problemas asegura que las categorías y valores sean consistentes y puedan agruparse o analizarse correctamente.
5. Manejo de Valores Faltantes
Los datos faltantes pueden invalidar análisis o algoritmos. Existen varias estrategias para manejarlos: eliminarlos (si la cantidad es pequeña y no afecta significativamente el conjunto de datos), imputarlos (estimar valores faltantes basándose en otros datos, aunque esto puede introducir suposiciones) o ajustar el análisis para que pueda manejar valores nulos.
6. Filtrado de Valores Atípicos (Outliers)
Los valores atípicos son observaciones que se desvían significativamente del resto de los datos. Pueden ser resultado de errores de entrada o representar eventos genuinos pero inusuales. Es crucial investigarlos: si son errores, deben corregirse o eliminarse; si son datos válidos, se debe decidir si incluirlos en el análisis o tratarlos por separado, dependiendo del objetivo.
7. Validación y Control de Calidad (QA)
Una vez aplicada la limpieza, es vital validar que el proceso haya sido exitoso y que los datos ahora cumplan con los estándares de calidad deseados. Esto implica verificar si los datos tienen sentido, si siguen las reglas definidas, y si ahora son aptos para el análisis previsto. Este paso a menudo requiere una revisión manual o el uso de herramientas de control de calidad de datos.
8. Documentación y Mantenimiento
Documentar el proceso de limpieza, los problemas encontrados y las soluciones aplicadas es crucial. Además, la limpieza de datos no es un evento único; es un proceso continuo. Establecer procedimientos para mantener la calidad de los datos a lo largo del tiempo (por ejemplo, validaciones en la entrada de datos, limpiezas periódicas) es fundamental.
Herramientas Clave para la Limpieza de Datos
El proceso de Data Cleansing puede ser complejo y laborioso, especialmente con grandes volúmenes de datos. Afortunadamente, existen diversas herramientas que pueden automatizar y facilitar muchas de estas tareas. La elección de la herramienta adecuada dependerá del tamaño de los datos, la complejidad de la limpieza requerida y el presupuesto.
Algunas de las herramientas destacadas en el mercado incluyen:
1. OpenRefine: Un software gratuito y de código abierto (anteriormente Google Refine). Es excelente para explorar, limpiar y transformar datos semiestructurados. Permite trabajar localmente y conectar con fuentes externas. Es muy útil para tareas como la reconciliación de datos y la identificación de duplicados.
2. Wrangler Trifacta: Destaca por su uso de aprendizaje automático para detectar inconsistencias y recomendar transformaciones. Su interfaz visual e intuitiva facilita la creación de pipelines de limpieza. Ofrece versiones gratuitas (desktop) y premium (Pro/Enterprise) con capacidades ampliadas y colaboración.
3. Winpure Clean & Match: Un software local conocido por su interfaz intuitiva y su enfoque en la limpieza y deduplicación de datos de clientes (CRM, listas de correo). Soporta una amplia gama de formatos y bases de datos (CSV, SQL Server, Salesforce, Oracle). Incluye funciones avanzadas como coincidencias parciales.
4. TIBCO Clarity: Un servicio basado en la nube (SaaS) ideal para limpiar y analizar datos sin procesar desde múltiples fuentes. Ofrece amplias funcionalidades de mapeo, transformación, perfilado y eliminación de duplicados. Una característica útil es la capacidad de deshacer transformaciones.
5. Melissa Clean Suite: Especialmente diseñado para integrarse con sistemas CRM como Salesforce y Microsoft Dynamics. Permite limpiar datos en tiempo real a medida que se ingresan, además de procesamientos por lotes. Incluye funciones de validación y corrección automática de contactos.
Además de estas herramientas dedicadas, muchas bibliotecas de programación como Pandas (para Python) o Dplyr (para R) son ampliamente utilizadas por científicos de datos para tareas de limpieza y preprocesamiento. Para entornos de Big Data distribuidos, herramientas como Optimus (basada en Apache Spark) ofrecen capacidades de limpieza escalables.
Desafíos Comunes en el Data Cleansing
Aunque el Data Cleansing es esencial, no está exento de desafíos:
- Pérdida de Información: La corrección de errores o la eliminación de duplicados o registros inválidos a veces implica descartar información. Es crucial minimizar esta pérdida y entender su impacto.
- Mantenimiento Continuo: La calidad de los datos puede degradarse con el tiempo a medida que se ingresan nuevos datos. Mantener los datos limpios requiere procesos y vigilancias constantes, lo cual puede ser costoso y consumir tiempo.
- Complejidad en Entornos Distribuidos: Limpiar datos que residen en múltiples sistemas o fuentes virtuales puede ser complicado y afectar el rendimiento.
- Proceso Iterativo: A menudo, la limpieza de datos es un proceso de descubrimiento y corrección que requiere múltiples iteraciones y un framework flexible para adaptarse a nuevos problemas encontrados.
Superar estos desafíos requiere una combinación de las herramientas adecuadas, procesos bien definidos y una cultura organizacional que valore la calidad de los datos.
Preguntas Frecuentes sobre Limpieza de Datos
¿Qué diferencia hay entre Data Cleansing y Data Validation?
La validación de datos generalmente ocurre en el punto de entrada y tiene como objetivo rechazar datos que no cumplen ciertas reglas predefinidas. El Data Cleansing es un proceso más amplio que implica identificar, corregir o eliminar errores en conjuntos de datos existentes, abordando no solo la validez sino también la consistencia, completitud y unicidad.
¿Con qué frecuencia se debe realizar la limpieza de datos?
La frecuencia ideal depende de la volatilidad y el volumen de los datos. Para datos que cambian constantemente (como los de clientes o transacciones), es ideal tener procesos de limpieza en tiempo real o muy frecuentes. Para datos más estáticos, las limpiezas periódicas (semanales, mensuales) pueden ser suficientes. Lo importante es que sea un proceso continuo, no una tarea única.
¿Quién es responsable de la limpieza de datos en una organización?
Aunque los científicos de datos o analistas suelen realizar la limpieza como parte de su preparación de datos, la responsabilidad de la calidad de los datos es compartida. Los equipos de TI, los administradores de bases de datos y los usuarios finales (quienes ingresan los datos) juegan un papel crucial. Idealmente, debería existir un rol o un equipo dedicado a la gobernanza de datos que supervise estos procesos.
¿Puede la automatización reemplazar por completo la limpieza manual de datos?
Las herramientas de automatización son extremadamente útiles para manejar grandes volúmenes y tareas repetitivas. Sin embargo, ciertos problemas de calidad de datos (como la interpretación de errores complejos o la validación de valores atípicos inusuales) pueden requerir juicio humano. La combinación de herramientas automatizadas y revisión manual suele ser el enfoque más efectivo.
¿Qué significa "Datos Sucios"?
Los "Datos Sucios" (Dirty Data) son datos que contienen errores, inconsistencias, duplicados, valores faltantes o están desactualizados. Son datos que no cumplen con los estándares de calidad requeridos para un análisis o uso fiable.
El Data Cleansing es, sin duda, un componente esencial de la gestión de datos moderna y un pilar para cualquier iniciativa de inteligencia de negocio o analítica avanzada. Asegurar la calidad de los datos no es solo una tarea técnica, es una estrategia fundamental para impulsar la eficiencia, mejorar la toma de decisiones y mantener una ventaja competitiva en el mercado actual, donde los datos son el nuevo petróleo. Invertir en procesos y herramientas de limpieza de datos es invertir en el futuro y la fiabilidad de tu organización.
Si quieres conocer otros artículos parecidos a Data Cleansing: Clave para Datos Confiables puedes visitar la categoría Bases de datos.
Aprende mas sobre MySQL