
Al igual que construir una amistad duradera requiere una base sólida de confianza, respeto y comunicación, la construcción de un sistema robusto para gestionar información requiere sus propios cimientos firmes. En el mundo digital, esta base se encuentra en las bases de datos. No son solo un lugar donde se guardan archivos de forma estática; son estructuras dinámicas y organizadas meticulosamente que permiten almacenar, gestionar, actualizar y recuperar grandes volúmenes de información de manera eficiente, segura y, lo más importante, interconectada. Comprender los principios fundamentales, la "base" sobre la que se construyen estos sistemas de información, es absolutamente esencial para cualquier profesional o entusiasta que interactúe con datos, desde desarrolladores de software y arquitectos de sistemas hasta analistas de datos y usuarios finales que buscan entender cómo funciona la información detrás de sus aplicaciones diarias.

La esencia de una base de datos relacional, que es el modelo más prevalente en la actualidad para una vasta gama de aplicaciones empresariales y web, reside precisamente en cómo se organiza la información y, crucialmente, en cómo se establecen y gestionan las conexiones lógicas entre las diferentes piezas de datos. Puedes visualizar una base de datos relacional no como un simple contenedor, sino como una red intrincada donde cada dato individual, o conjunto de datos, no está aislado, sino ligado a otros de manera lógica y predefinida. Esta capacidad de interconexión y de definir relaciones claras entre los datos es lo que otorga a las bases de datos relacionales su inmenso poder, su flexibilidad para responder a consultas complejas y su capacidad para mantener la coherencia a lo largo del tiempo.
- La "Base" Estructural: Tablas, Campos y Tipos de Datos
- Identidad y Conexión: Claves y Relaciones
- Modelando el Mundo: Tipos de Relaciones
- La Importancia de la Integridad y la Eficiencia
- Interactuando con la Base: SQL
- Conceptos Fundamentales en un Vistazo
- Preguntas Comunes sobre los Fundamentos de Bases de Datos
La "Base" Estructural: Tablas, Campos y Tipos de Datos
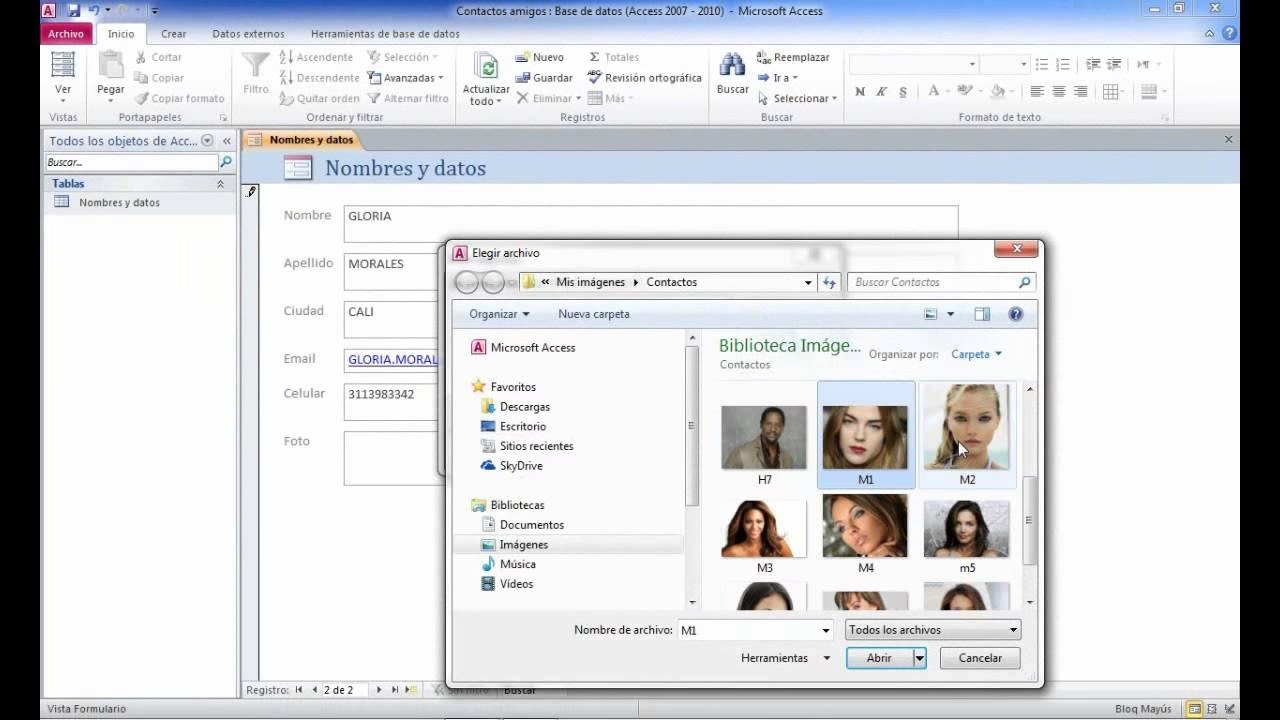
En el nivel más fundamental de una base de datos relacional, nos encontramos con las tablas. Cada tabla es una colección organizada de datos estructurados sobre un tema o entidad específica del mundo real o del dominio de la aplicación. Si pensamos en una base de datos para gestionar las operaciones de una universidad, podríamos tener tablas dedicadas a "Estudiantes", "Cursos", "Profesores", "Departamentos", etc. Cada tabla está diseñada para mantener información homogénea y relacionada conceptualmente.
Dentro de cada tabla, la información se organiza en columnas, que se conocen como campos o atributos. Un campo representa una característica o propiedad particular de la entidad que la tabla está modelando. Por ejemplo, en la tabla "Estudiantes", los campos podrían incluir "ID_Estudiante", "Nombre", "Apellido", "FechaNacimiento", "DireccionCorreo", etc. Cada campo está diseñado para almacenar un tipo específico de dato (tipo de dato), como texto (VARCHAR), números enteros (INT), números decimales (DECIMAL), fechas (DATE), valores booleanos (BOOLEAN), entre otros. La elección adecuada del tipo de dato para cada campo es importante para la eficiencia del almacenamiento, la precisión de los datos y el rendimiento de las consultas.
Cada fila en una tabla se denomina registro o tupla, y representa una instancia individual de la entidad. Por ejemplo, una fila en la tabla "Estudiantes" representaría a un estudiante específico con todos sus datos (valores para cada campo). La definición cuidadosa de las tablas, sus campos y los tipos de datos apropiados es el primer paso y uno de los más cruciales en el proceso de diseño de una base de datos. Un buen diseño inicial es la diferencia entre un sistema de información eficiente y robusto y uno que es propenso a errores y difícil de mantener.
Identidad y Conexión: Claves y Relaciones
Para que las bases de datos relacionales puedan gestionar la información de forma no redundante y permitir la vinculación de datos a través de diferentes tablas, se utilizan conceptos clave como las identidades únicas y los enlaces lógicos. Aquí es donde entran en juego las claves y las relaciones.
Una Clave Primaria es un campo o un conjunto de campos dentro de una tabla que sirve para identificar de manera única cada fila (registro) de esa tabla. Es un identificador único e irrepetible. Por ejemplo, en la tabla "Estudiantes", el campo "ID_Estudiante" podría ser la clave primaria. Garantiza que no haya dos estudiantes con el mismo ID. Las claves primarias son fundamentales para la integridad de los datos y son el punto de partida para establecer conexiones.
Una Clave Foránea es un campo o un conjunto de campos en una tabla (la tabla "hija" o "referenciadora") que hace referencia a la clave primaria de otra tabla (la tabla "padre" o "referenciada"). Es a través de estas claves foráneas que se establecen las relaciones lógicas entre las tablas. Por ejemplo, en una tabla "InscripcionesCurso", podríamos tener campos como "ID_Inscripcion" (clave primaria de esta tabla), "ID_Estudiante" y "ID_Curso". "ID_Estudiante" sería una clave foránea que referencia la clave primaria en la tabla "Estudiantes", e "ID_Curso" sería una clave foránea que referencia la clave primaria en la tabla "Cursos". Así, un registro en "InscripcionesCurso" vincula a un estudiante específico con un curso específico.
Estas relaciones no son solo conceptuales; son impuestas por el Sistema de Gestión de Bases de Datos (SGBD) mediante restricciones de integridad referencial. Esto significa que el SGBD puede evitar acciones que romperían los vínculos, como intentar eliminar un estudiante si todavía hay inscripciones de ese estudiante registradas en la tabla "InscripcionesCurso".
Modelando el Mundo: Tipos de Relaciones
La forma en que las entidades se relacionan entre sí en el mundo real (o en el dominio de la aplicación) se modela en la base de datos mediante diferentes tipos de relaciones:
- Relación Uno a Uno (1:1): Se da cuando un registro en la Tabla A se asocia con exactamente un registro en la Tabla B, y viceversa. Aunque menos comunes que otras, se utilizan en escenarios específicos. Un ejemplo podría ser la relación entre una tabla "Empleados" y una tabla "InformacionConfidencialEmpleado", donde cada empleado tiene (como máximo) un registro de información confidencial, y cada registro confidencial pertenece a un único empleado. A menudo, se implementa compartiendo la misma clave primaria o usando una clave foránea única.
- Relación Uno a Muchos (1:N): Este es el tipo de relación más frecuente y fundamental. Un registro en la Tabla A puede estar asociado con cero, uno o muchos registros en la Tabla B, pero un registro en la Tabla B está asociado con exactamente un registro en la Tabla A. El ejemplo clásico es la relación entre "Departamentos" y "Empleados": un departamento puede tener muchos empleados, pero cada empleado pertenece a un único departamento. Se implementa colocando la clave primaria de la tabla del lado "uno" (Departamento) como clave foránea en la tabla del lado "muchos" (Empleados).
- Relación Muchos a Muchos (N:M): Ocurre cuando un registro en la Tabla A puede estar asociado con muchos registros en la Tabla B, y un registro en la Tabla B puede estar asociado con muchos registros en la Tabla A. La relación entre "Estudiantes" y "Cursos" es un ejemplo típico: un estudiante puede inscribirse en varios cursos, y un curso tiene muchos estudiantes inscritos. Este tipo de relación no puede implementarse directamente con solo dos tablas. Requiere una tercera tabla intermedia, a menudo llamada tabla de unión, de enlace o asociativa (como nuestra tabla "InscripcionesCurso" del ejemplo anterior). Esta tabla de unión típicamente contiene claves foráneas de ambas tablas originales, y su clave primaria a menudo es una clave compuesta formada por estas dos claves foráneas, o un ID único propio.
Comprender y modelar correctamente estas relaciones es vital para un diseño de base de datos eficiente y para la capacidad de realizar consultas que reflejen las conexiones lógicas de los datos.
La Importancia de la Integridad y la Eficiencia
Las relaciones y las restricciones de integridad asociadas a ellas (como las restricciones de clave primaria y clave foránea) son la columna vertebral de la integridad de los datos en una base de datos relacional. Aseguran que los datos sean consistentes, precisos y fiables. Sin estas reglas, sería fácil introducir datos erróneos o inconsistentes que harían que la base de datos perdiera su utilidad. Otras restricciones importantes incluyen la unicidad (para campos que no son clave primaria pero deben ser únicos, como un nombre de usuario) y las restricciones de verificación (para asegurar que los valores de un campo cumplan ciertas condiciones, como que una edad sea mayor que cero).
Además de la integridad, un diseño relacional bien pensado y la correcta implementación de relaciones y claves son cruciales para el rendimiento. Permiten al SGBD optimizar las consultas, minimizando la cantidad de datos que necesita procesar para responder a una pregunta. Por ejemplo, al buscar todos los libros de un autor, el SGBD puede usar la clave foránea en la tabla "Libros" y la clave primaria en la tabla "Autores" (posiblemente con la ayuda de índices) para encontrar rápidamente los libros correctos sin tener que escanear toda la tabla de libros o de autores. Los índices son estructuras de datos especiales que mejoran la velocidad de búsqueda de datos; son como el índice de un libro que te permite encontrar información sin leer todo el contenido.
El proceso de diseño de bases de datos, incluyendo la identificación de entidades, atributos y relaciones, a menudo sigue principios de normalización para lograr un diseño óptimo que equilibre la reducción de redundancia, la integridad de los datos y la eficiencia de las consultas. La normalización es un tema extenso, pero su objetivo principal es evitar problemas como las anomalías de inserción, actualización y eliminación que surgen de diseños deficientes.
Interactuando con la Base: SQL
Una vez que la "base" y las relaciones de una base de datos están establecidas y pobladas con datos, la forma principal de interactuar con ella es a través de un lenguaje de consulta. El lenguaje estándar y más utilizado para bases de datos relacionales es SQL (Structured Query Language). SQL permite a los usuarios y aplicaciones realizar una amplia gama de operaciones:
- SELECT: La operación más común, utilizada para recuperar datos de una o más tablas. Aquí es donde el conocimiento de las relaciones es fundamental, ya que a menudo se utilizan cláusulas JOIN para combinar datos de tablas relacionadas y obtener una vista completa de la información que se necesita. Los JOINs permiten "unir" filas de dos o más tablas basándose en un campo relacionado (típicamente la clave foránea y primaria).
- INSERT: Se utiliza para añadir nuevas filas (registros) a una tabla. Es crucial que los datos insertados cumplan con las restricciones de integridad definidas para la tabla y sus relaciones.
- UPDATE: Permite modificar los valores de campos existentes en una o varias filas que cumplen ciertas condiciones especificadas en la consulta.
- DELETE: Se utiliza para eliminar filas de una tabla que cumplen ciertas condiciones. Las restricciones de clave foránea pueden impedir la eliminación de registros si están siendo referenciados por otras tablas (dependiendo de cómo se configure la restricción, como CASCADE, NO ACTION, SET NULL, etc.).
- CREATE TABLE, ALTER TABLE, DROP TABLE: Comandos DDL (Data Definition Language) para definir, modificar o eliminar la estructura de la base de datos (tablas, campos, claves, restricciones, etc.).
- CREATE INDEX, DROP INDEX: Comandos para crear o eliminar índices, que son estructuras que mejoran el rendimiento de las operaciones de búsqueda y filtrado.
El dominio de SQL y la comprensión de cómo opera sobre la estructura relacional de la base de datos son habilidades esenciales para cualquier profesional de datos. Es el lenguaje universal que permite comunicarse con la mayoría de los SGBD relacionales.
Conceptos Fundamentales en un Vistazo
| Término | Definición |
|---|---|
| Tabla | Colección estructurada de datos sobre una entidad específica, organizada en filas y columnas. Es el componente básico de almacenamiento. |
| Campo | Columna dentro de una tabla que almacena un tipo particular de dato para cada registro. Define los atributos de la entidad. |
| Registro (Fila) | Una fila individual en una tabla, que representa una instancia de la entidad. Contiene valores para cada campo. |
| Tipo de Dato | Define el tipo de información que un campo puede almacenar (texto, número, fecha, booleano, etc.), impactando el almacenamiento y las operaciones permitidas. |
| Clave Primaria | Campo o conjunto de campos que identifica de forma única cada registro en una tabla. No puede contener valores nulos y sus valores deben ser únicos. |
| Clave Foránea | Campo o conjunto de campos en una tabla que referencia la clave primaria de otra tabla, estableciendo un vínculo lógico y manteniendo la integridad referencial. |
| Relación | Vínculo lógico definido entre dos o más tablas, basado en campos comunes (típicamente claves primarias y foráneas), que describe cómo se conectan los datos entre tablas. |
| Integridad de Datos | Precisión, consistencia y fiabilidad de los datos en la base de datos, asegurada mediante reglas y restricciones (claves, unicidad, verificación, referencial). |
| Normalización | Proceso de diseño para organizar la estructura de la base de datos, dividiendo tablas para reducir redundancia y mejorar la integridad y eficiencia. |
| SQL | Lenguaje estándar para consultar, manipular y definir la estructura de bases de datos relacionales. |
| SGBD | Sistema de Gestión de Bases de Datos; el software que administra y permite interactuar con la base de datos. |
Preguntas Comunes sobre los Fundamentos de Bases de Datos
Para solidificar la comprensión de estos conceptos básicos, abordemos algunas preguntas frecuentes:
¿Por qué no simplemente guardar todos los datos en una sola tabla grande?
Guardar toda la información en una sola tabla (un diseño "plano") lleva a una enorme redundancia de datos. Por ejemplo, si tienes la información del autor repetida para cada libro que ha escrito, cualquier cambio en los datos del autor (un apellido, una dirección) requeriría actualizar múltiples registros, lo que es propenso a errores, consume espacio innecesario y dificulta el mantenimiento. Además, hace que las consultas sean menos flexibles y que la integridad de los datos sea difícil de mantener. El diseño relacional distribuye la información en tablas separadas y vinculadas lógicamente a través de relaciones, eliminando la redundancia y facilitando la gestión, la consistencia y la eficiencia de las consultas.
¿Qué sucede si intento insertar un registro en una tabla "hija" con una clave foránea que no existe en la tabla "padre"?
Si la restricción de clave foránea está correctamente definida en el SGBD, la operación de inserción será rechazada por violar la integridad referencial. Esta es una forma fundamental en que las bases de datos mantienen la consistencia: aseguran que los vínculos entre las tablas sean siempre válidos. No puedes tener, por ejemplo, una inscripción a un curso para un estudiante cuyo ID no existe en la tabla maestra de estudiantes. Esto evita datos huérfanos o inconsistentes.
¿Cómo el diseño de la base de datos afecta el rendimiento de una aplicación?
El diseño de la base de datos es uno de los factores más críticos para el rendimiento de una aplicación que la utiliza. Un diseño normalizado y con relaciones bien definidas, junto con la aplicación de índices adecuados en los campos clave y foráneos (y otros campos frecuentemente usados en búsquedas y filtros), permite que el SGBD recupere y manipule datos de manera eficiente. Tablas mal diseñadas, con demasiada redundancia, relaciones incorrectas, o falta de índices, pueden llevar a consultas extremadamente lentas, bloqueos de datos, problemas de escalabilidad a medida que el volumen de datos crece, y un uso ineficiente de los recursos del servidor.
¿Son las bases de datos relacionales el único tipo que existe?
No, aunque son las más tradicionales y extendidas para muchas aplicaciones que requieren alta integridad y transacciones complejas, existen otros modelos de bases de datos. Estos, a menudo agrupados bajo el término "NoSQL" (Not Only SQL), incluyen bases de datos de documentos (optimizadas para datos semi-estructurados), bases de datos clave-valor (para acceso rápido por clave simple), bases de datos de columnas anchas (para grandes volúmenes de datos dispersos) y bases de datos de grafos (excelentes para modelar relaciones complejas y redes). Cada tipo está diseñado para manejar diferentes tipos de datos, patrones de acceso y requisitos de escalabilidad, y la elección depende de las necesidades específicas del proyecto. Sin embargo, los principios de estructurar, organizar y gestionar datos persisten en diferentes formas en todos los modelos.
¿Qué es un SGBD y cuál es su papel?
Un SGBD (Sistema de Gestión de Bases de Datos) es el software intermediario que permite a los usuarios, aplicaciones y otros sistemas interactuar con la base de datos física. No es la base de datos en sí (que son los datos almacenados en archivos), sino el motor que la gestiona. El SGBD se encarga de la creación, mantenimiento, organización, seguridad, respaldo, concurrencia (permitir que múltiples usuarios accedan al mismo tiempo) y optimización del acceso a los datos. Interpreta los comandos SQL, gestiona las transacciones para asegurar la atomicidad y durabilidad de las operaciones, aplica las restricciones de integridad definidas y optimiza las operaciones de lectura y escritura para asegurar un funcionamiento eficiente y seguro de la base de datos. Ejemplos populares incluyen MySQL, PostgreSQL, Oracle Database, SQL Server, SQLite, MariaDB y otros.
En conclusión, la "base" de una base de datos va mucho más allá del simple almacenamiento de información. Se trata de una estructura cuidadosa de tablas, campos, claves (primarias y foráneas) y, fundamentalmente, relaciones que permiten organizar, conectar y gestionar datos de manera lógica, eficiente e íntegra. Al igual que una amistad se fortalece sobre una base de confianza y relaciones sólidas, una base de datos robusta se construye sobre un diseño estructurado y vínculos lógicos que permiten que la información fluya correctamente, se mantenga consistente y pueda ser consultada de manera potente. Comprender estos principios es el primer paso y el más importante para dominar el arte de la gestión de datos y construir sistemas de información robustos y confiables que sustentan el mundo digital moderno.
Si quieres conocer otros artículos parecidos a La Base de Datos: Fundamentos y Relaciones puedes visitar la categoría Bases de datos.
Aprende mas sobre MySQL