
Comprender cómo se mueve y se transforma la información dentro de un sistema es fundamental para diseñar aplicaciones robustas y eficientes. La arquitectura de flujo de datos surge como una abstracción esencial en la computación, delineando la transmisión de datos a través de nodos y módulos específicos dentro de la arquitectura de tu sistema. Esta perspectiva es crucial para optimizar el rendimiento del sistema y habilitar el procesamiento de datos, especialmente en entornos distribuidos.
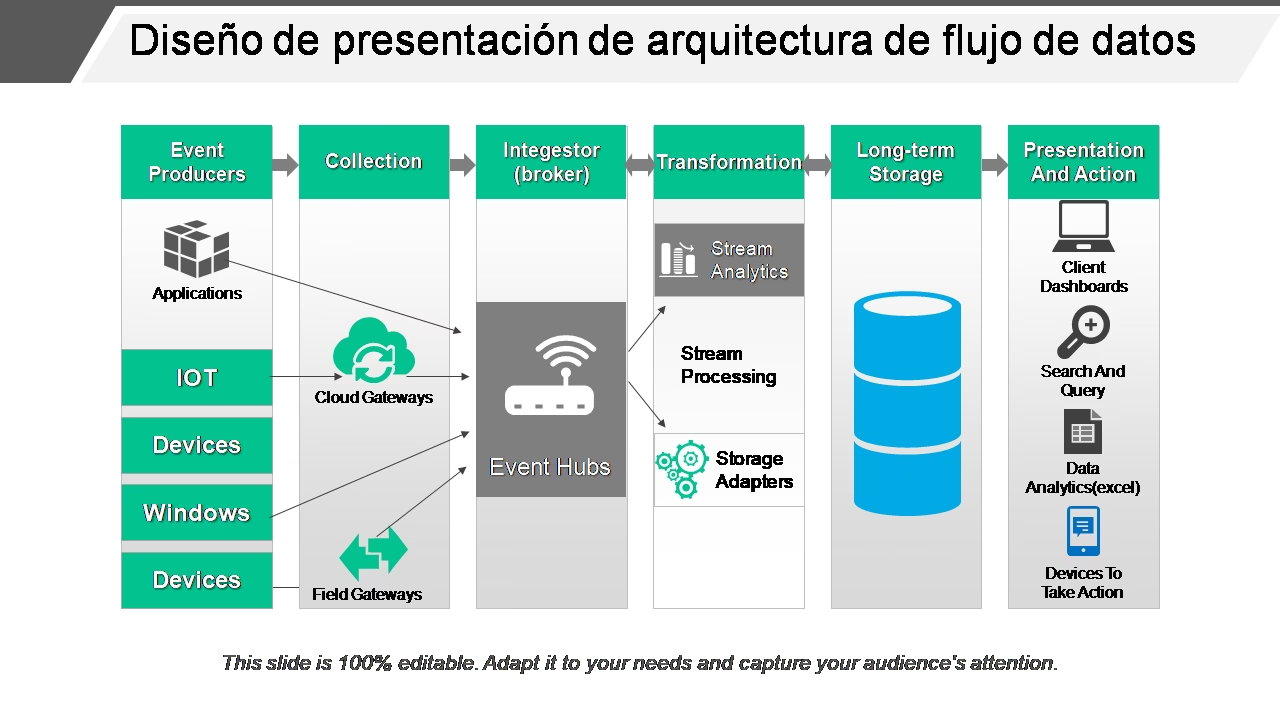
Este artículo se adentra en el concepto de la arquitectura de flujo de datos, explorando sus fundamentos, los patrones más comunes, sus puntos fuertes y débiles, y algunos aspectos a considerar al implementarla.
¿Qué es la Arquitectura de Flujo de Datos?
En esencia, la arquitectura de flujo de datos es una representación esquemática que ilustra cómo la información viaja y se procesa dentro de un sistema de software. En este paradigma, los sistemas de software se visualizan no como una serie de pasos lógicos ejecutándose, sino como una secuencia de transformaciones aplicadas a subconjuntos más pequeños de datos de entrada. Los datos fluyen a través de diferentes módulos o componentes de transformación hasta que alcanzan su estado o destino final (la salida).
A diferencia de otras arquitecturas que se centran en el control de la ejecución o los componentes que realizan acciones, la arquitectura de flujo de datos pone el foco principal en los datos en sí mismos y en cómo cambian a medida que pasan por el sistema. Cada paso en el flujo toma datos de entrada, realiza una operación sobre ellos y produce datos de salida, que a su vez pueden servir como entrada para el siguiente paso.
Detrás de Escena: Secuencias de Ejecución
La arquitectura de flujo de datos no es un concepto monolítico; puede manifestarse a través de diferentes tipos de secuencias de ejecución, cada una con sus propias características y casos de uso. Los tres tipos principales incluyen la arquitectura Secuencial por Lotes, la arquitectura Tubería y Filtro, y la arquitectura de Control de Proceso.
Secuencial por Lotes
Como un modelo de procesamiento de datos más tradicional y a menudo utilizado en entornos de procesamiento por lotes (batch processing), la arquitectura Secuencial por Lotes permite que un subsistema de transformación de datos solo inicie su proceso después de que el subsistema anterior haya completado completamente su tarea. Esto implica que los datos fluyen en grupos o lotes de un subsistema a otro de manera estrictamente secuencial. Es un enfoque simple y directo, fácil de entender y gestionar, pero puede ser ineficiente si los lotes son grandes o si se requiere un procesamiento rápido.
Imagine un proceso donde primero se recopilan todas las transacciones del día, luego se validan todas juntas, después se procesan todas para actualizar saldos y finalmente se generan todos los informes. Cada uno de estos pasos (recopilación, validación, procesamiento, generación de informes) sería un subsistema, y el siguiente no comienza hasta que el anterior termina con *todos* los datos del lote.
Tubería y Filtro
La arquitectura de Tubería y Filtro (Pipe and Filter) es un patrón arquitectónico que organiza un sistema en dos componentes principales: filtros y tuberías. Los filtros son los componentes activos que procesan, transforman y refinan los datos entrantes. Cada filtro es independiente y realiza una tarea específica (por ejemplo, ordenar datos, formatear datos, extraer información). Las tuberías, por otro lado, son los canales de comunicación unidireccionales que transfieren datos entre diferentes filtros sin aplicar ninguna lógica o transformación propia. Actúan simplemente como conductos.
Este patrón promueve la modularidad y la reutilización, ya que los filtros pueden combinarse de diversas maneras utilizando diferentes tuberías. Permite la ejecución tanto secuencial (un filtro alimenta al siguiente) como paralela (múltiples filtros operando en diferentes datos simultáneamente, si el sistema lo permite), lo que puede proporcionar concurrencia y alto rendimiento. Un ejemplo clásico es el procesamiento de texto en sistemas operativos Unix/Linux, donde comandos como grep (filtro para buscar patrones), sort (filtro para ordenar) y uniq (filtro para eliminar duplicados) se conectan mediante tuberías (|).
Control de Proceso
A diferencia de las arquitecturas Secuencial por Lotes y Tubería y Filtro, la arquitectura de Control de Proceso no sigue una secuencia de procesamiento de datos lineal definida por componentes. En cambio, se centra en mantener un sistema en un estado deseado o reaccionar a cambios en tiempo real. Contiene típicamente una unidad de procesamiento (que altera variables de control o parámetros del sistema) y una unidad controladora (que monitorea el estado del sistema, calcula la cantidad de cambios necesarios y dirige la unidad de procesamiento). El flujo de datos aquí es más un ciclo de retroalimentación: datos del estado del sistema entran al controlador, el controlador calcula acciones, datos de acciones van al procesador, el procesador cambia el sistema, y el nuevo estado del sistema genera nuevos datos. Es especialmente adecuada para casos de uso donde se requiere monitoreo y ajuste continuo, como el diseño de software para sistemas embebidos, la gestión de plantas de energía nuclear, o sistemas automotrices como los frenos antibloqueo (ABS), donde se necesita reaccionar rápidamente a las condiciones cambiantes.
Ventajas y Desventajas de la Arquitectura de Flujo de Datos
Cada tipo de arquitectura de flujo de datos presenta un conjunto único de pros y contras que influyen en su idoneidad para diferentes aplicaciones.
- Secuencial por Lotes:
- Ventajas:
- Más fácil de gestionar y entender debido a su flujo de procesamiento lineal y simple.
- Ideal para tareas que no requieren resultados inmediatos y pueden acumularse.
- Desventajas:
- Experimenta alta latencia, ya que cada lote completo debe ser procesado antes de pasar al siguiente.
- Poca flexibilidad para el procesamiento en tiempo real o interactivo.
- Ventajas:
- Tubería y Filtro:
- Ventajas:
- Permite la ejecución tanto secuencial como paralela, proporcionando concurrencia y alto rendimiento.
- Promueve la modularidad, reutilización y mantenibilidad de los filtros.
- Los filtros son independientes y pueden desarrollarse y probarse por separado.
- Desventajas:
- El mantenimiento puede ser complejo si el número de filtros y tuberías crece mucho.
- No soporta fácilmente la interacción dinámica o la comunicación bidireccional entre filtros.
- Puede haber una sobrecarga de transformación de datos si los datos deben convertirse entre formatos para cada filtro.
- Ventajas:
- Control de Proceso:
- Ventajas:
- Permite implementar cambios en los algoritmos de control sin interrumpir significativamente el sistema en operación (si está bien diseñado).
- Ideal para sistemas que requieren monitoreo y ajuste continuo en tiempo real.
- Desventajas:
- Puede ser difícil manejar perturbaciones inesperadas o fallos complejos que no estén previstos en los algoritmos de control.
- El diseño del controlador y la unidad de procesamiento puede ser complejo.
- Ventajas:
Para facilitar la comparación, podemos resumir las principales características en una tabla:
| Característica | Secuencial por Lotes | Tubería y Filtro | Control de Proceso |
|---|---|---|---|
| Flujo de Datos | En lotes, secuencial estricto | Continuo a través de tuberías | Cíclico (retroalimentación) |
| Componentes Clave | Subsistemas secuenciales | Filtros (transformación), Tuberías (transporte) | Unidad de Procesamiento, Unidad Controladora |
| Paralelismo | Limitado (entre lotes si es posible) | Alto potencial | Según el diseño |
| Latencia | Alta | Variable (depende de la cadena) | Baja (para reaccionar rápido) |
| Complejidad | Baja a Moderada | Moderada a Alta | Alta |
| Casos de Uso Típicos | Reportes diarios, nóminas, procesamiento de fin de día | Procesamiento de texto, compiladores, ETL ligero | Sistemas embebidos, control industrial, robótica |
¿Flujo de Datos vs. Flujo de Control?
Es importante distinguir la arquitectura de flujo de datos de la arquitectura de flujo de control. Mientras que el flujo de datos se centra en cómo la información se mueve y se transforma, el flujo de control se centra en el orden en que se ejecutan las operaciones o las funciones. En un sistema de flujo de control, el programa dicta la secuencia de pasos a seguir (por ejemplo, utilizando condicionales, bucles, llamadas a funciones). En un sistema de flujo de datos, la disponibilidad de los datos de entrada es lo que desencadena la ejecución de una transformación.
Aunque a menudo coexisten en sistemas complejos, conceptualmente son diferentes. El flujo de datos describe la dependencia de los datos entre operaciones, mientras que el flujo de control describe la dependencia temporal o de orden entre operaciones. Entender ambos es clave para diseñar sistemas robustos y eficientes.
Aplicaciones y Consideraciones
La arquitectura de flujo de datos, en sus diversas formas, se aplica ampliamente en numerosos dominios de la informática. Más allá de los ejemplos ya mencionados, se encuentra en:
- Procesamiento de Streams de Datos: Sistemas que manejan flujos continuos e ilimitados de datos (como clics en una web, datos de sensores) a menudo utilizan variantes de tuberías y filtros.
- Sistemas ETL (Extracción, Transformación, Carga): Aunque a menudo se implementan con un enfoque secuencial por lotes, los pasos de transformación dentro de un proceso ETL a menudo siguen un patrón de flujo de datos.
- Computación Paralela y Distribuida: Muchos frameworks y modelos de programación para sistemas distribuidos se basan en el concepto de que los datos fluyen a través de una red de nodos de procesamiento.
- Lenguajes de Programación Visuales: Algunos entornos de desarrollo permiten construir aplicaciones conectando visualmente componentes que representan transformaciones de datos.
Al diseñar un sistema basado en la arquitectura de flujo de datos, es crucial considerar:
- Granularidad de los Filtros/Subsistemas: ¿Qué tan grande o pequeña debe ser la tarea de cada componente? Una granularidad incorrecta puede llevar a sobrecarga o a componentes demasiado complejos.
- Manejo de Errores: ¿Cómo se propagan y manejan los errores a través del flujo? Un fallo en un componente puede detener todo el proceso.
- Formato de Datos: Asegurarse de que los datos de salida de un componente sean compatibles con los datos de entrada del siguiente es vital.
- Gestión del Estado: Los filtros idealmente deberían ser sin estado (stateless) para facilitar la paralelización, pero esto no siempre es posible.
Preguntas Frecuentes sobre la Arquitectura de Flujo de Datos
Aquí respondemos algunas preguntas comunes sobre este tipo de arquitectura:
- ¿Es la arquitectura de flujo de datos lo mismo que la arquitectura de microservicios? No, aunque los microservicios pueden implementar patrones de flujo de datos internamente o comunicarse a través de flujos de datos (como colas de mensajes), la arquitectura de flujo de datos es un patrón de diseño que se enfoca en el movimiento y transformación de datos, y puede ser aplicado dentro de un monolito o a través de microservicios.
- ¿Cuándo debería considerar usar una arquitectura de flujo de datos? Es particularmente útil cuando tienes un proceso que implica una serie clara de transformaciones que deben aplicarse a los datos, o cuando necesitas procesar grandes volúmenes de datos o streams de manera eficiente.
- ¿Cuáles son algunas herramientas comunes para implementar arquitecturas de flujo de datos? Muchas herramientas de ETL (como Apache NiFi, Talend), frameworks de procesamiento de streams (como Apache Flink, Apache Kafka Streams) y sistemas de computación distribuida (como Apache Spark) implementan o facilitan patrones de flujo de datos.
- ¿Puede una arquitectura de flujo de datos manejar bucles o ciclos? La arquitectura Tubería y Filtro estándar es unidireccional y no maneja ciclos fácilmente. Otras variantes o arquitecturas (como la de Control de Proceso) están diseñadas para manejar retroalimentación y ciclos de manera efectiva.
- ¿Son los filtros siempre independientes? Idealmente sí, para maximizar la reusabilidad y el paralelismo. Sin embargo, en la práctica, a veces pueden compartir recursos o depender de un contexto externo, lo que puede limitar algunos de sus beneficios.
En resumen, la arquitectura de flujo de datos ofrece una perspectiva poderosa para diseñar sistemas, centrándose en el viaje y la transformación de la información. Al comprender sus diferentes tipos y características, los arquitectos y desarrolladores pueden elegir el enfoque más adecuado para construir sistemas eficientes, mantenibles y escalables.
Si quieres conocer otros artículos parecidos a Arquitectura de Flujo de Datos Explicada puedes visitar la categoría Bases de datos.
Aprende mas sobre MySQL