
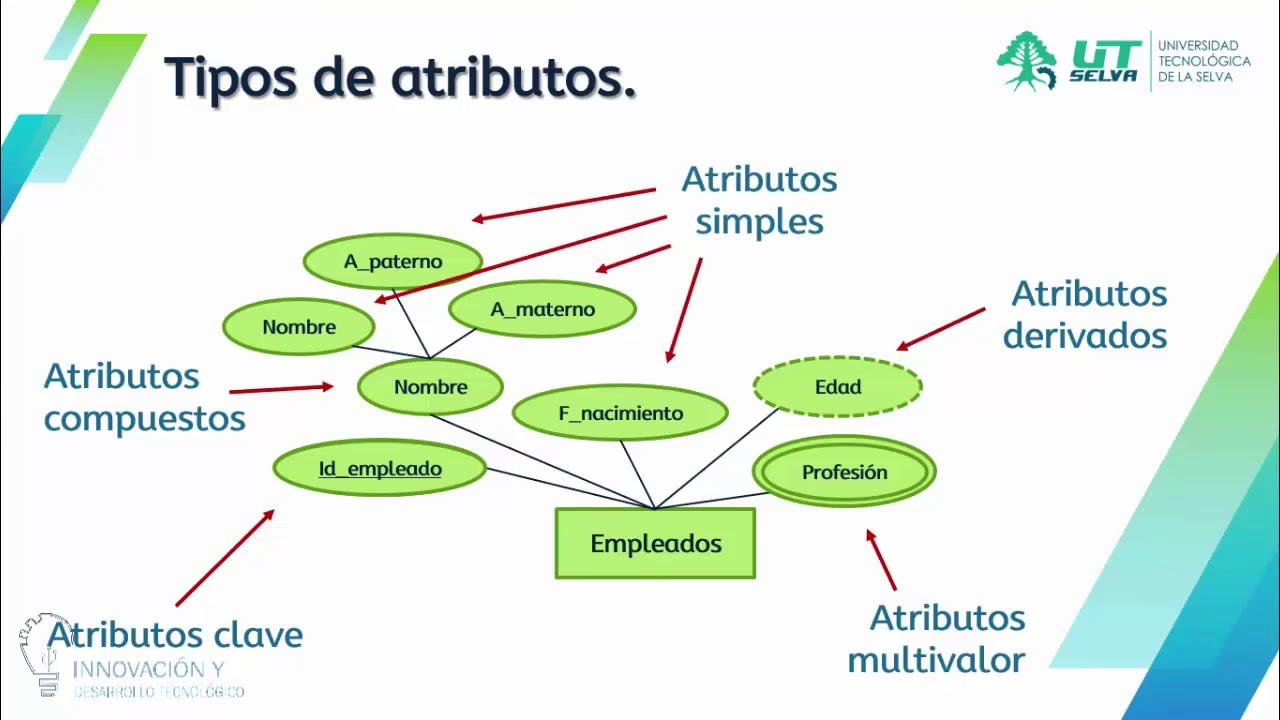
En el vasto universo de las bases de datos, comprender la estructura y organización de la información es fundamental. Uno de los conceptos clave para lograr un diseño eficiente y coherente es el de los atributos. Los atributos son las propiedades o características que describen una entidad (como una persona, un producto o un lugar). Sin embargo, no todos los atributos son iguales en su complejidad. Algunos pueden ser simples, representando un único valor indivisible, mientras que otros son más complejos y pueden dividirse en partes más pequeñas. Aquí es donde entra en juego el concepto de atributo compuesto.

Un atributo compuesto es aquel que puede descomponerse en subpartes o componentes significativos. Aunque conceptualmente representa una única característica, internamente está formado por varios elementos relacionados. Piensa, por ejemplo, en la dirección de una persona. Aunque la consideramos una sola 'dirección', esta se compone típicamente de elementos como la calle, el número, la ciudad, el estado/provincia y el código postal. Cada una de estas subpartes es un componente del atributo compuesto 'Dirección'.
La importancia de identificar los atributos compuestos radica en cómo decidimos representar esta información en una base de datos relacional. Una representación adecuada puede simplificar las consultas, mejorar la integridad de los datos y facilitar el mantenimiento.
- ¿Qué Distingue un Atributo Compuesto?
- Representación de Atributos Compuestos en SQL
- Ejemplos Prácticos en SQL (Representación en una Columna Única)
- Ventajas y Desventajas de Representar Atributos Compuestos en una Sola Columna
- La Alternativa Preferida: Columnas Separadas
- Atributos Compuestos vs. Claves Compuestas
- Preguntas Frecuentes (FAQ)
- Conclusión
¿Qué Distingue un Atributo Compuesto?
La principal característica de un atributo compuesto es su divisibilidad. A diferencia de un atributo simple (como, por ejemplo, la fecha de nacimiento, que generalmente se trata como una unidad indivisible), un atributo compuesto puede fraccionarse en componentes que tienen significado propio y que, a menudo, necesitamos manipular o consultar de forma individual. Otros ejemplos comunes de atributos compuestos incluyen:
- Nombre Completo: Puede dividirse en Nombre, Segundo Nombre (opcional) y Apellido.
- Información de Contacto: Podría incluir Email, Teléfono Fijo, Teléfono Móvil.
- Dimensiones de un Producto: Podría componerse de Alto, Ancho y Profundidad.
Identificar estos atributos compuestos durante la fase de diseño de la base de datos (por ejemplo, al crear un diagrama Entidad-Relación) es crucial. Nos permite decidir la mejor manera de almacenar esta información en las tablas, lo cual impactará directamente en la flexibilidad y eficiencia de nuestro sistema.
Representación de Atributos Compuestos en SQL
En el ámbito de las bases de datos relacionales y SQL, existen principalmente dos enfoques para representar un atributo conceptualmente compuesto:
- Almacenar cada componente en una columna separada: Este es el enfoque más común y generalmente recomendado en bases de datos relacionales. Cada subparte del atributo compuesto se convierte en una columna individual en la tabla. Por ejemplo, en lugar de tener una columna única 'Dirección', tendríamos columnas separadas como 'Calle', 'Ciudad', 'CodigoPostal', etc.
- Almacenar todos los componentes concatenados en una única columna: Este enfoque menos común y a menudo problemático implica guardar todas las subpartes del atributo compuesto como una sola cadena de texto dentro de una columna. Por ejemplo, la dirección completa ('Calle 123, Ciudad X, 10001') se almacenaría en una sola columna 'DireccionCompleta'.
Veamos ejemplos prácticos de cómo se podría implementar el segundo enfoque en SQL, extrayendo luego los componentes. Es importante notar que, aunque este enfoque es posible, a menudo introduce complejidades y problemas de normalización.
Ejemplos Prácticos en SQL (Representación en una Columna Única)
Consideremos los ejemplos proporcionados para ilustrar cómo se representaría y manipularía un atributo compuesto almacenado en una sola columna.
Ejemplo 1: Tabla de Empleados con Información de Contacto Compuesta
Supongamos que queremos almacenar el email y el número de teléfono de un empleado en una sola columna llamada `ContactoInfo`, separándolos por una coma.
Primero, creamos la tabla:
CREATE TABLE Empleado (
 EmpleadoID INT PRIMARY KEY,
 Nombre VARCHAR(50),
 ContactoInfo VARCHAR(100) -- Atributo Compuesto conceptualmente
);
Luego, insertamos algunos datos:
INSERT INTO Empleado (EmpleadoID, Nombre, ContactoInfo)
VALUES
(1, 'Juan Pérez', '[email protected], 123-456-7890'),
(2, 'María García', '[email protected], 456-789-0123'),
(3, 'Carlos López', '[email protected], 789-012-3456');
La tabla `Empleado` se vería así:
| EmpleadoID | Nombre | ContactoInfo |
|---|---|---|
| 1 | Juan Pérez | [email protected], 123-456-7890 |
| 2 | María García | [email protected], 456-789-0123 |
| 3 | Carlos López | [email protected], 789-012-3456 |
Ahora, si necesitamos consultar el email y el número de teléfono por separado, debemos usar funciones de manipulación de cadenas disponibles en SQL. La forma exacta de estas funciones puede variar ligeramente entre diferentes sistemas de gestión de bases de datos (DBMS), pero el concepto es el mismo: encontrar la posición del separador (la coma) y extraer las subcadenas antes y después de él.
Una consulta para extraer Email y Teléfono podría ser (usando sintaxis similar a la de la fuente, común en MySQL o SQLite):
SELECT
 Nombre,
 SUBSTR(ContactoInfo, 1, INSTR(ContactoInfo, ',') - 1) AS Email,
 TRIM(SUBSTR(ContactoInfo, INSTR(ContactoInfo, ',') + 1)) AS NumeroTelefono
FROM
 Empleado;
Explicación de las funciones:
INSTR(Cadena, Subcadena): Devuelve la posición de la primera aparición de `Subcadena` dentro de `Cadena`.SUBSTR(Cadena, PosicionInicio, Longitud): Extrae una subcadena de `Cadena` comenzando en `PosicionInicio` y con una longitud especificada. Si se omite la longitud, extrae hasta el final de la cadena.TRIM(Cadena): Elimina espacios (u otros caracteres especificados) del inicio y/o final de `Cadena`.
En este caso, `INSTR(ContactoInfo, ',')` encuentra la posición de la coma. `SUBSTR(ContactoInfo, 1, INSTR(ContactoInfo, ',') - 1)` extrae la parte desde el inicio hasta justo antes de la coma (el email). `SUBSTR(ContactoInfo, INSTR(ContactoInfo, ',') + 1)` extrae la parte desde después de la coma hasta el final (el número de teléfono). `TRIM` se usa para eliminar cualquier espacio extra que pueda haber después de la coma.
El resultado de esta consulta sería:
| Nombre | NumeroTelefono | |
|---|---|---|
| Juan Pérez | [email protected] | 123-456-7890 |
| María García | [email protected] | 456-789-0123 |
| Carlos López | [email protected] | 789-012-3456 |
Ejemplo 2: Tabla de Estudiantes con Dirección Compuesta
De manera similar, podemos almacenar una dirección que conceptualmente es compuesta (Calle, Ciudad, Código Postal) en una única columna `Direccion`.
Creación de la tabla:
CREATE TABLE Estudiante (
 EstudianteID INT PRIMARY KEY,
 Nombre VARCHAR(50),
 Direccion VARCHAR(100) -- Atributo Compuesto conceptualmente
);
Inserción de datos:
INSERT INTO Estudiante (EstudianteID, Nombre, Direccion)
VALUES
(1, 'Ana Ruiz', 'Calle Falsa 123, Apto 2, Ciudad A, 10001'),
(2, 'Pedro Gómez', 'Avenida Siempreviva 742, Suite 3B, Ciudad B, 20002'),
(3, 'Sofía Hernández', 'Paseo del Prado 45, Ciudad C, 30003');
Tabla `Estudiante`:
| EstudianteID | Nombre | Direccion |
|---|---|---|
| 1 | Ana Ruiz | Calle Falsa 123, Apto 2, Ciudad A, 10001 |
| 2 | Pedro Gómez | Avenida Siempreviva 742, Suite 3B, Ciudad B, 20002 |
| 3 | Sofía Hernández | Paseo del Prado 45, Ciudad C, 30003 |
Extraer los componentes (Calle, Ciudad, PIN) de una cadena con múltiples separadores (comas) es más complejo y requiere anidar o combinar funciones de cadena. La consulta para extraer Calle, Ciudad y PIN podría ser:
SELECT
 Nombre,
 SUBSTR(Direccion, 1, INSTR(Direccion, ',') - 1) AS Calle,
 TRIM(SUBSTR(Direccion, INSTR(Direccion, ',') + 1,
 INSTR(SUBSTR(Direccion, INSTR(Direccion, ',') + 1), ',') - 1)) AS Ciudad,
 TRIM(SUBSTR(Direccion, LENGTH(Direccion) - INSTR(REVERSE(Direccion), ',') + 2)) AS PIN
FROM
 Estudiante;
Explicación adicional de funciones:
LENGTH(Cadena): Devuelve la longitud de la cadena.REVERSE(Cadena): Devuelve la cadena con los caracteres en orden inverso.
La lógica para extraer la ciudad es más compleja porque es la parte entre la primera y la segunda coma. La lógica para el PIN utiliza `REVERSE` e `INSTR` para encontrar la posición de la *última* coma desde el final de la cadena, y luego `SUBSTR` extrae la parte desde ahí hasta el final.
El resultado de esta consulta sería:
| Nombre | Calle | Ciudad | PIN |
|---|---|---|---|
| Ana Ruiz | Calle Falsa 123 | Apto 2, Ciudad A | 10001 |
| Pedro Gómez | Avenida Siempreviva 742 | Suite 3B, Ciudad B | 20002 |
| Sofía Hernández | Paseo del Prado 45 | Ciudad C | 30003 |
Como se puede observar, la extracción de componentes de un atributo compuesto almacenado como una sola cadena puede volverse bastante complicada y propensa a errores, especialmente si el formato de la cadena no es estrictamente consistente o si los componentes pueden contener el carácter separador.
Ventajas y Desventajas de Representar Atributos Compuestos en una Sola Columna
Aunque el enfoque de almacenar componentes en una sola columna fue ilustrado, es crucial entender sus implicaciones:
Ventajas (muy limitadas en bases de datos relacionales)
- Puede parecer conceptualmente simple en las primeras etapas del diseño.
Desventajas (significativas)
- Violación de la Primera Forma Normal (1NF): La 1NF establece que cada columna debe contener valores atómicos, es decir, indivisibles. Almacenar múltiples componentes en una sola columna viola esta regla fundamental, lo que lleva a bases de datos menos flexibles y más difíciles de manejar.
- Dificultad para Consultar y Manipular Componentes: Realizar búsquedas, ordenar resultados o agrupar por uno de los componentes requiere el uso de complejas funciones de cadena, como se vio en los ejemplos. Esto es ineficiente y propenso a errores.
- Problemas de Integridad de Datos: Es difícil asegurar que los datos se ingresen siempre en un formato consistente (por ejemplo, 'email, telefono' vs 'telefono; email' vs 'email telefono'). Esto complica aún más la extracción de datos.
- Indexación Ineficiente: No se pueden crear índices sobre los componentes individuales dentro de la cadena, lo que penaliza el rendimiento de las consultas que filtran o buscan por estos componentes.
- Mayor Complejidad en la Lógica de Aplicación: La responsabilidad de parsear y validar los datos recae en la aplicación que interactúa con la base de datos, en lugar de ser manejada por el propio sistema de base de datos.
La Alternativa Preferida: Columnas Separadas
Dado que las desventajas de almacenar atributos compuestos en una sola columna son considerables en un entorno relacional, la práctica recomendada es almacenar cada componente del atributo compuesto en su propia columna. Siguiendo esta buena práctica de diseño, las tablas `Empleado` y `Estudiante` se verían así:
Tabla Empleado (Diseño Normalizado)
CREATE TABLE EmpleadoNormalizado (
 EmpleadoID INT PRIMARY KEY,
 Nombre VARCHAR(50),
 Email VARCHAR(100),
 NumeroTelefono VARCHAR(20)
);
Consultar el email o el teléfono es trivial:
SELECT Nombre, Email, NumeroTelefono FROM EmpleadoNormalizado;Tabla Estudiante (Diseño Normalizado)
CREATE TABLE EstudianteNormalizado (
 EstudianteID INT PRIMARY KEY,
 Nombre VARCHAR(50),
 Calle VARCHAR(100),
 Ciudad VARCHAR(50),
 CodigoPostal VARCHAR(10)
);
Consultar la ciudad o el código postal es igualmente sencillo:
SELECT Nombre, Calle, Ciudad, CodigoPostal FROM EstudianteNormalizado;Este enfoque, aunque requiere más columnas, simplifica drásticamente las consultas, mejora la integridad de los datos (cada columna puede tener su propio tipo de dato y restricciones) y permite una indexación eficiente de los componentes individuales. Cumple con los principios de normalización, lo cual es fundamental para el diseño de bases de datos robustas y mantenibles.
Atributos Compuestos vs. Claves Compuestas
Es importante no confundir el concepto de atributo compuesto con el de clave compuesta. Aunque ambos términos involucran la idea de 'composición', se refieren a cosas diferentes en el contexto de bases de datos:
- Atributo Compuesto: Es un atributo que puede dividirse en subpartes significativas (ej: Dirección -> Calle, Ciudad, Código Postal). Se refiere a la estructura interna de un único concepto de dato.
- Clave Compuesta: Es una clave primaria o candidata que consta de dos o más atributos (columnas) que, juntos, identifican de forma única cada fila en una tabla (ej: una tabla de `Pedidos` podría usar `(NumeroPedido, LineaPedido)` como clave primaria compuesta). Se refiere a la combinación de columnas utilizada para garantizar la unicidad de los registros.
Mientras que un atributo compuesto se centra en la descomposición conceptual de una propiedad, una clave compuesta se centra en el uso de múltiples propiedades (que pueden ser atributos simples o incluso componentes de atributos compuestos si están en columnas separadas) para identificar registros de forma única.
Preguntas Frecuentes (FAQ)
- ¿Siempre debo dividir un atributo compuesto en columnas separadas?
Sí, en el diseño de bases de datos relacionales, la buena práctica es casi siempre almacenar los componentes de un atributo compuesto en columnas separadas. Esto mejora la normalización, la integridad y la facilidad de consulta. - ¿Cuándo podría ser aceptable almacenar un atributo compuesto en una sola columna?
En escenarios muy específicos donde el rendimiento de las consultas sobre los componentes individuales no es crítico, el formato de la cadena es estrictamente controlado, o si la base de datos no es relacional. Sin embargo, incluso en estos casos, las desventajas suelen superar las ventajas. - ¿Un atributo multivalor es lo mismo que un atributo compuesto?
No. Un atributo compuesto se divide en subpartes (ej: Dirección -> Calle, Ciudad). Un atributo multivalor puede tener múltiples valores para un mismo registro (ej: Teléfonos de una persona, puede tener varios números). Ambos violan la Primera Forma Normal si se almacenan en una sola columna, pero son conceptos distintos. - ¿Cómo identifico atributos compuestos al diseñar una base de datos?
Analiza cada atributo de tus entidades. Pregúntate si ese atributo podría dividirse lógicamente en partes más pequeñas que tengan significado propio y que podrías necesitar consultar o manipular individualmente. Si la respuesta es sí, es probable que sea un atributo compuesto.
Conclusión
Los atributos compuestos son un concepto importante en el diseño de bases de datos. Representan propiedades que, aunque conceptualmente unitarias, se componen de partes más pequeñas y significativas. Si bien es técnicamente posible almacenar estos atributos en una sola columna concatenando sus componentes, esta práctica conlleva serias desventajas en términos de integridad de datos, eficiencia de consulta y cumplimiento de los principios de normalización.
La forma estándar y recomendada de manejar atributos compuestos en bases de datos relacionales y SQL es dividir el atributo conceptual en sus componentes y almacenar cada componente en una columna separada en la tabla. Este enfoque, alineado con la normalización, simplifica las operaciones de base de datos, mejora el rendimiento y garantiza una mayor robustez y mantenibilidad del esquema. Entender y aplicar correctamente el manejo de atributos compuestos es un paso clave hacia el diseño de bases de datos eficientes y bien estructuradas.
Si quieres conocer otros artículos parecidos a ¿Qué es un Atributo Compuesto en SQL? puedes visitar la categoría Bases de datos.
Aprende mas sobre MySQL