
En la era de la inteligencia artificial y el manejo masivo de datos no estructurados, las bases de datos tradicionales a menudo se quedan cortas. Imágenes, audio, texto libre, datos de sensores... toda esta información compleja necesita ser gestionada y, crucialmente, consultada de maneras que van más allá de las coincidencias exactas. Aquí es donde entran en juego las bases de datos vectoriales, una tecnología fundamental que está redefiniendo cómo interactuamos con la información en el contexto de la IA.
- ¿Qué es una Base de Datos Vectorial?
- Vectores, Embeddings y Alta Dimensionalidad
- Búsqueda Vectorial: Encontrando Similitud, No Exactitud
- Base de Datos Vectorial vs. Vectorización (en Programación)
- ¿SQL o NoSQL? La Integración de Capacidades Vectoriales
- El Rol Clave en la Generación Aumentada por Recuperación (RAG)
- Casos de Uso Adicionales
- Tabla Comparativa: Base de Datos Vectorial vs. Otros
- Preguntas Frecuentes sobre Bases de Datos Vectoriales
- Conclusión
¿Qué es una Base de Datos Vectorial?
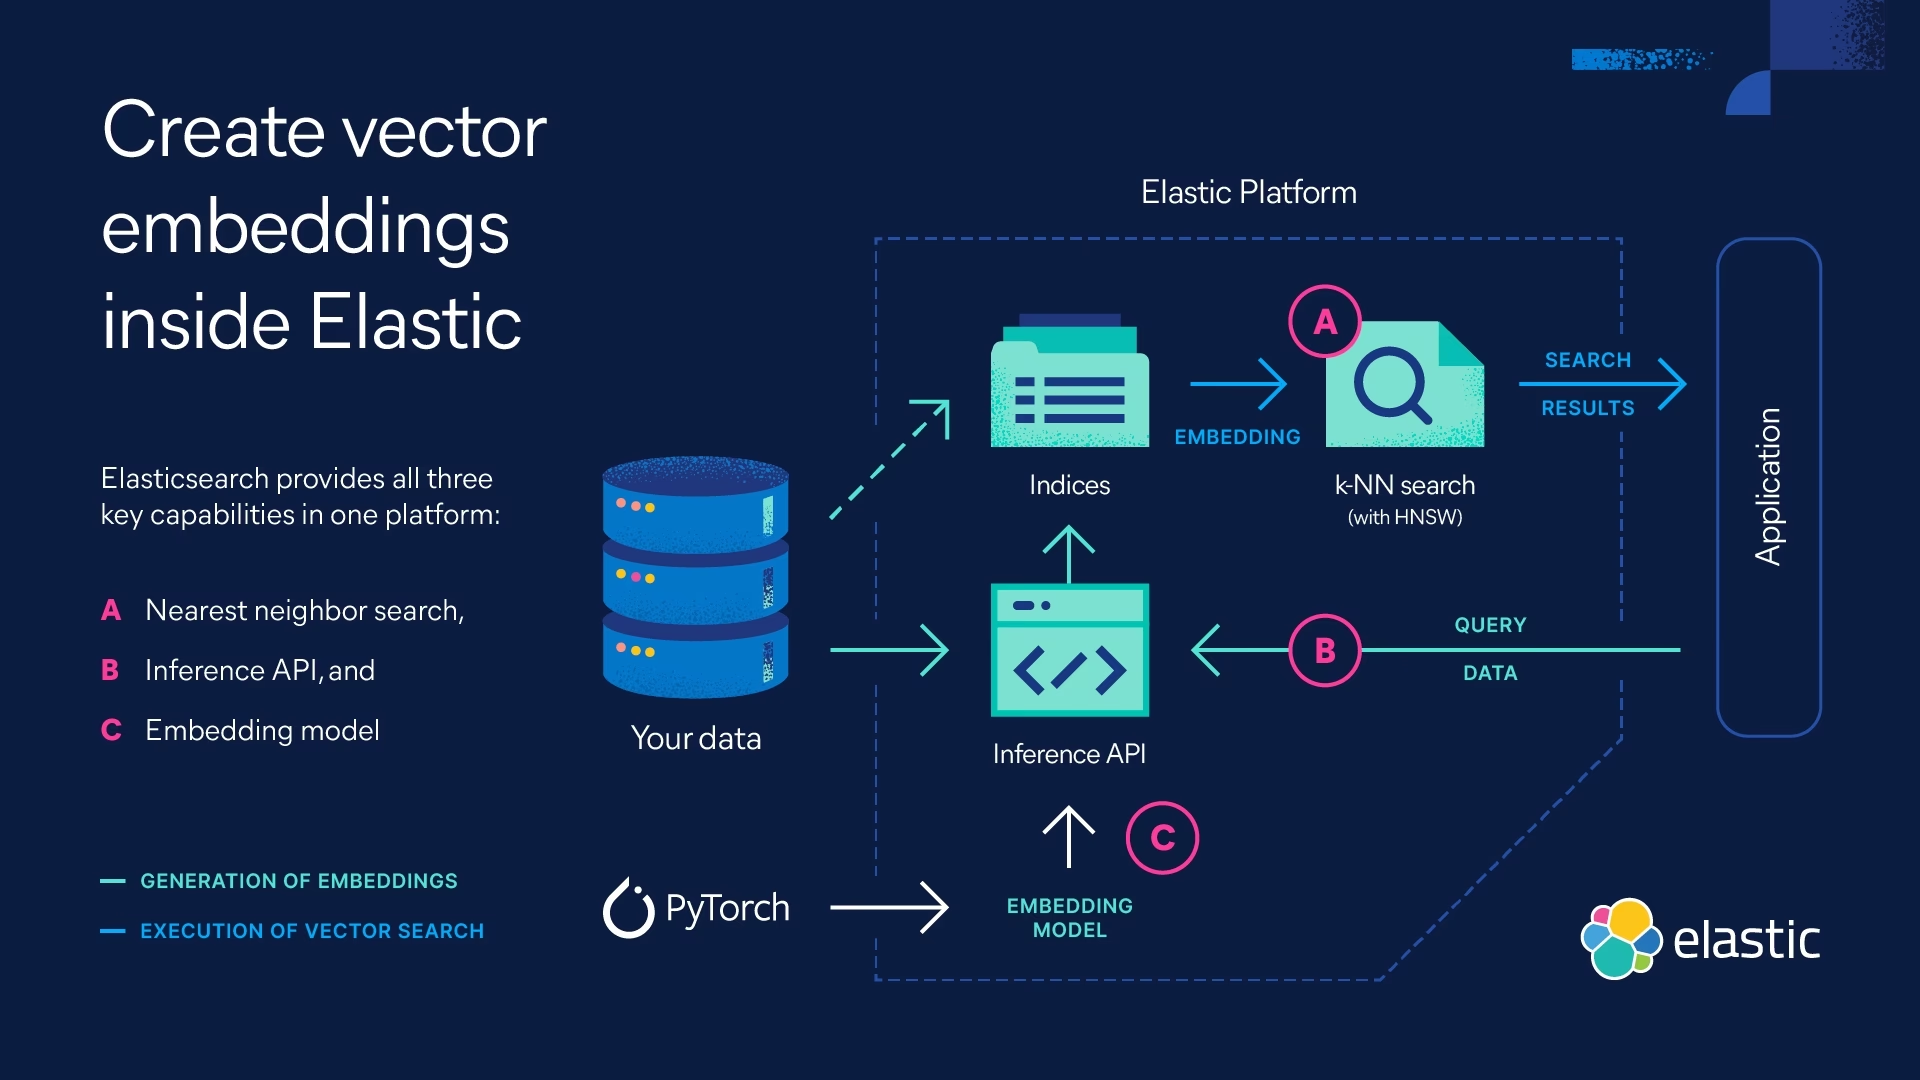
Una Base de Datos Vectorial es un tipo especializado de base de datos diseñada para almacenar y gestionar información en forma de vectores. Pero, ¿qué significa esto? En este contexto, un vector es una representación numérica de un objeto de datos (como una imagen, un fragmento de texto, un archivo de audio, etc.). Estas representaciones numéricas, a menudo llamadas Vectores (Embeddings), son esencialmente listas de números (puntos en un espacio multidimensional) que capturan las características y el significado semántico del objeto original.
La magia de estas bases de datos reside en su capacidad para indexar y buscar eficientemente a través de estos vectores en espacios de alta dimensionalidad. Mientras que una base de datos tradicional podría buscar coincidencias exactas de valores o rangos, una base de datos vectorial busca la *similitud* entre vectores. Esto se logra midiendo la distancia o el ángulo entre los vectores en este espacio de alta dimensión: cuanto más cercanos estén dos vectores, más similares serán los objetos que representan.
Es importante diferenciar una base de datos vectorial de una simple librería o índice de búsqueda vectorial. Una base de datos vectorial es una solución completa de gestión de datos. No solo almacena los vectores (embeddings), sino que también permite almacenar y filtrar metadatos asociados a ellos. Ofrecen características esenciales para entornos de producción como escalabilidad, manejo de cambios dinámicos en los datos, backups y funcionalidades de seguridad. Un índice vectorial, por otro lado, es solo una estructura optimizada para realizar la búsqueda por similitud sobre un conjunto estático de vectores.
Vectores, Embeddings y Alta Dimensionalidad
El concepto central es el del vector como representación. Estos vectores son generados típicamente por modelos de Machine Learning (ML) o APIs especializadas en embeddings. Por ejemplo, un modelo puede procesar una imagen y generar un vector de cientos o miles de números que codifican características visuales como colores, formas, texturas, etc. De manera similar, un modelo de lenguaje puede tomar un párrafo de texto y generar un vector que representa su significado semántico, su tono o su tema.
La característica clave de estos vectores es su alta dimensionalidad. Hablamos de vectores que pueden tener cientos o incluso miles de dimensiones. Cada dimensión en este vector corresponde a una característica o propiedad específica del objeto de datos. Esta alta dimensionalidad permite capturar matices muy finos y complejos del dato original de una manera que las representaciones de baja dimensión no podrían.
Búsqueda Vectorial: Encontrando Similitud, No Exactitud
La principal operación en una base de datos vectorial es la Búsqueda Vectorial. A diferencia de la búsqueda tradicional basada en palabras clave o valores exactos, la búsqueda vectorial se basa en la similitud entre vectores. Cuando un usuario realiza una consulta (por ejemplo, sube una imagen para encontrar imágenes similares, o escribe una pregunta en lenguaje natural), esta consulta se convierte primero en un vector (utilizando el mismo modelo que generó los embeddings en la base de datos). Luego, la base de datos busca los vectores almacenados que son más 'cercanos' al vector de consulta en el espacio de alta dimensión.
Para realizar esta búsqueda eficientemente en conjuntos de datos masivos, las bases de datos vectoriales emplean algoritmos de indexación y búsqueda avanzados. Algunos de los algoritmos más conocidos incluyen HNSW (Hierarchical Navigable Small World), IVF (Inverted File) y DiskANN. Estos algoritmos construyen estructuras de índice que permiten encontrar los vecinos más cercanos a un vector de consulta mucho más rápido que si se comparara con cada vector en la base de datos (una búsqueda lineal que sería inviable para grandes volúmenes de datos).
La búsqueda vectorial es la base de muchas aplicaciones modernas, como:
- Búsqueda de imágenes o videos por contenido visual.
- Sistemas de recomendación (encontrar productos o contenido similar a lo que le gustó al usuario).
- Detección de duplicados (encontrar texto o imágenes muy similares).
- Identificación de anomalías (encontrar datos que son significativamente diferentes del patrón general).
- Búsqueda semántica (encontrar documentos o párrafos que significan lo mismo, aunque usen palabras diferentes).
Base de Datos Vectorial vs. Vectorización (en Programación)
Es crucial no confundir el concepto de "vector" en una base de datos vectorial con el de "vectorización" en el contexto de la programación y la ciencia de datos. La vectorización en programación se refiere a la optimización del rendimiento al realizar operaciones en conjuntos de datos (arrays o vectores en el sentido matemático simple) de manera paralela, aplicando una única operación a múltiples puntos de datos simultáneamente. Esto aprovecha la arquitectura de las CPUs y GPUs modernas para acelerar cálculos, especialmente en bibliotecas como NumPy en Python. Es una técnica computacional.
Por otro lado, un vector en una base de datos vectorial (un embedding) es una *representación* numérica de un objeto complejo. La base de datos vectorial está optimizada para *almacenar*, *indexar* y *buscar* estos vectores de alta dimensión basados en su similitud semántica. Aunque ambos conceptos involucran listas o arrays de números, su propósito y aplicación son distintos: uno es una técnica para acelerar cálculos sobre datos estructurados (o semi-estructurados), el otro es una forma de representar datos complejos no estructurados para permitir la búsqueda por similitud.
¿SQL o NoSQL? La Integración de Capacidades Vectoriales
Una pregunta común es si una base de datos vectorial es un tipo de base de datos SQL o NoSQL. La respuesta no es binaria. Inicialmente, surgieron bases de datos puramente vectoriales, diseñadas desde cero para gestionar embeddings y metadatos mínimos. Sin embargo, una tendencia creciente es la integración de capacidades vectoriales en bases de datos NoSQL y también relacionales (SQL) existentes.
Este enfoque integrado permite almacenar los vectores (embeddings) y los datos originales correspondientes *juntos* en la misma base de datos. Esto ofrece varias ventajas:
- Consistencia de Datos: Los embeddings y los datos originales están siempre sincronizados.
- Menor Costo: Se evita la necesidad de replicar grandes volúmenes de datos en una base de datos vectorial separada.
- Simplificación de la Arquitectura: Se reduce la complejidad al tener una única base de datos para datos y sus representaciones vectoriales.
- Mejor Rendimiento para Datos Multimodales: Facilita operaciones que involucran tanto la búsqueda por similitud como el acceso a los datos originales y sus metadatos.
Por lo tanto, las capacidades de base de datos vectorial no son exclusivas de un tipo (SQL o NoSQL), sino que se están convirtiendo en una característica valiosa que se añade a diferentes tipos de bases de datos para soportar las demandas de las aplicaciones modernas impulsadas por IA.
El Rol Clave en la Generación Aumentada por Recuperación (RAG)
Uno de los casos de uso más destacados y actuales para las bases de datos vectoriales es en la arquitectura de RAG (Retrieval-Augmented Generation - Generación Aumentada por Recuperación). Esta técnica mejora las capacidades de los Grandes Modelos de Lenguaje (LLMs) como ChatGPT, dándoles acceso a información personalizada y actualizada que no estaba incluida en sus datos de entrenamiento originales.
El proceso RAG típicamente funciona así:
- Se toma un conjunto de datos personalizados (documentos, artículos, manuales, etc.) y se divide en fragmentos.
- Cada fragmento se convierte en un vector (embedding) utilizando un modelo de lenguaje.
- Estos vectores (embeddings) se almacenan en una base de datos vectorial, junto con los metadatos relevantes o una referencia al fragmento de texto original.
- Cuando un usuario hace una pregunta o proporciona un 'prompt', esta consulta también se convierte en un vector.
- Se realiza una búsqueda vectorial en la base de datos para encontrar los fragmentos de datos personalizados cuyos vectores son más similares al vector de la consulta.
- Los fragmentos de datos recuperados se añaden al prompt original del usuario, proporcionando contexto relevante al LLM.
- El LLM utiliza este prompt aumentado con contexto para generar una respuesta más precisa, relevante y basada en los datos personalizados.
Este enfoque RAG permite a los LLMs superar limitaciones como el conocimiento desactualizado, las alucinaciones (inventar información) y los límites de tokens en el prompt, al proporcionarles acceso a una base de conocimiento externa y específica del dominio. Las bases de datos vectoriales son esenciales en este proceso porque permiten la recuperación rápida y precisa de la información más relevante a partir de una consulta en lenguaje natural.
Casos de Uso Adicionales
Más allá de RAG, las bases de datos vectoriales potencian una amplia gama de aplicaciones:
- Procesamiento de Lenguaje Natural (PLN): Búsqueda semántica, clasificación de texto por contenido, identificación de temas.
- Reconocimiento de Imágenes y Video: Búsqueda de contenido visual similar, etiquetado automático, detección de objetos.
- Sistemas de Recomendación: Recomendar productos, películas, música o noticias basándose en la similitud entre los ítems o entre los perfiles de usuario.
- Detección de Fraude y Anomalías: Identificar patrones de comportamiento o transacciones inusuales que se desvían significativamente de la norma.
- Memoria Persistente para Agentes de IA: Permitir que los agentes de IA 'recuerden' interacciones o información relevante a lo largo del tiempo.
Tabla Comparativa: Base de Datos Vectorial vs. Otros
| Característica | Base de Datos Vectorial | Librería/Índice de Búsqueda Vectorial | Base de Datos Tradicional (SQL/NoSQL) |
|---|---|---|---|
| Gestión Completa de Datos | Sí (almacena vectores, metadatos, ofrece persistencia, backups, seguridad) | No (solo indexación y búsqueda sobre datos proporcionados) | Sí (almacena datos estructurados/semi-estructurados, ofrece persistencia, backups, seguridad) |
| Optimizado para... | Almacenamiento y búsqueda de vectores (embeddings) de alta dimensión | Búsqueda eficiente de vecinos cercanos | Consultas sobre datos estructurados/semi-estructurados (filtros, uniones, agregaciones) |
| Tipo de Búsqueda Principal | Similitud Semántica / Vecinos Cercanos (Nearest Neighbor Search) | Vecinos Cercanos | Coincidencia exacta, rangos, patrones |
| Escalabilidad y Dinamismo | Diseñada para escalar con grandes volúmenes de vectores y manejar cambios | Puede requerir reconstrucción del índice para cambios dinámicos o escalado manual | Diseñada para escalar con grandes volúmenes de datos estructurados/semi-estructurados |
| Datos Multimodales | Ideal para gestionar y buscar datos multimodales a través de sus embeddings | Solo maneja los vectores, no los datos originales directamente | Puede almacenar datos multimodales, pero la búsqueda por similitud es limitada |
Preguntas Frecuentes sobre Bases de Datos Vectoriales
¿Qué tipo de datos puedo almacenar en una base de datos vectorial?
Principalmente, almacenas representaciones vectoriales (embeddings) de datos no estructurados o semi-estructurados como texto, imágenes, audio, video, datos de sensores, etc. También puedes almacenar metadatos asociados a estos vectores.
¿Cómo se crean los vectores (embeddings)?
Los vectores (embeddings) se generan utilizando modelos de Machine Learning o APIs especializadas. Estos modelos procesan el dato original y lo transforman en una lista de números que captura sus características y significado.
¿Necesito entender álgebra lineal para usar una base de datos vectorial?
No es estrictamente necesario para *usar* la base de datos, ya que la complejidad de la gestión de vectores y la búsqueda se abstrae. Sin embargo, entender conceptos básicos como dimensiones, distancia y similitud (aunque sea de forma intuitiva) ayuda a comprender cómo funcionan y por qué son efectivas.
¿Una base de datos vectorial es lo mismo que "vectorizar" datos en programación?
No, son conceptos relacionados pero distintos. "Vectorizar" en programación se refiere a optimizar cálculos sobre arrays de números. Una base de datos vectorial almacena y busca representaciones numéricas (embeddings) de datos complejos.
¿Las bases de datos vectoriales solo sirven para aplicaciones de IA?
Aunque su uso principal está impulsado por la IA y el Machine Learning (especialmente para búsqueda por similitud y RAG), cualquier aplicación que necesite encontrar ítems similares basados en características complejas (no solo coincidencias exactas) puede beneficiarse de una base de datos vectorial.
Conclusión
Las bases de datos vectoriales son una tecnología esencial en el panorama actual de los datos, especialmente con el auge de la inteligencia artificial. Permiten a las organizaciones gestionar y consultar eficazmente vastos volúmenes de datos no estructurados y semi-estructurados, desbloqueando capacidades como la búsqueda por similitud semántica y potenciando arquitecturas avanzadas como la Generación Aumentada por Recuperación (RAG). Ya sean soluciones puramente vectoriales o capacidades integradas en bases de datos existentes, los vectores y la búsqueda vectorial son componentes clave para construir las aplicaciones inteligentes del mañana.
Si quieres conocer otros artículos parecidos a Bases de Datos Vectoriales: Impulsando la IA puedes visitar la categoría Bases de datos.
Aprende mas sobre MySQL