
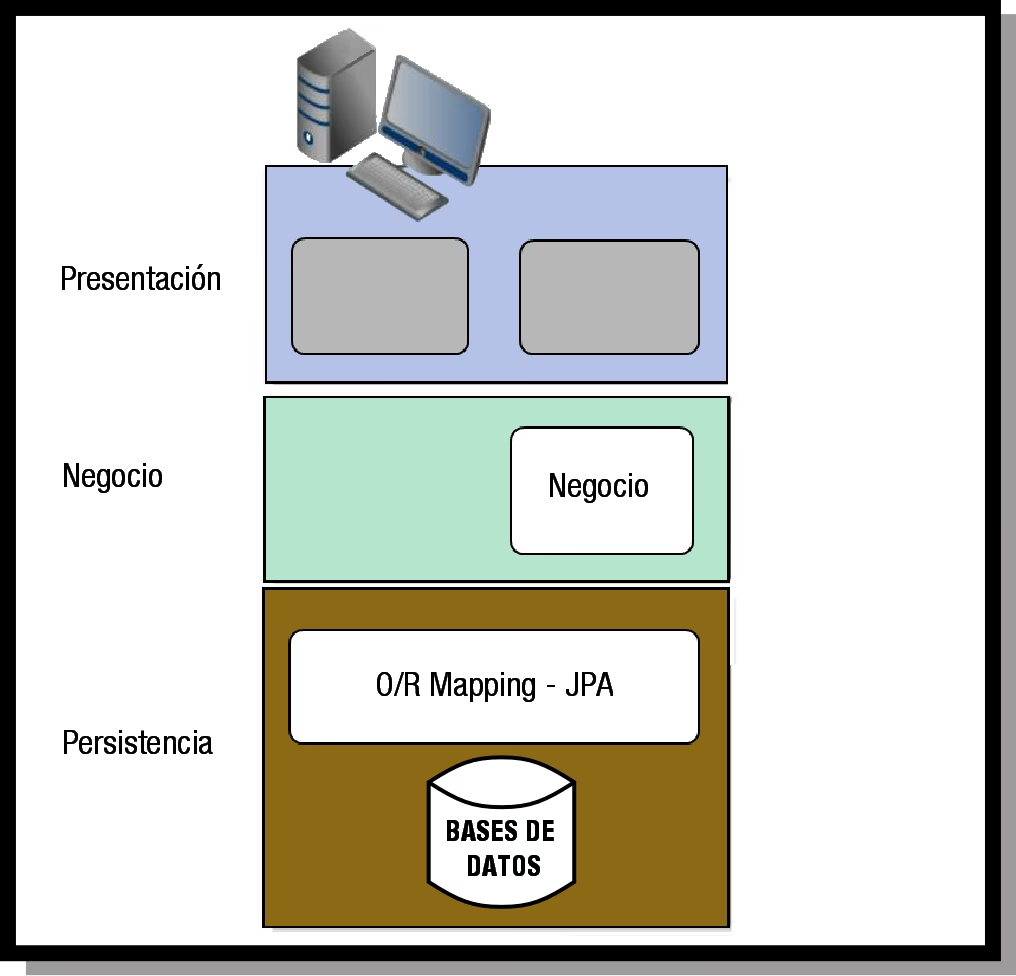
En el vasto mundo del desarrollo de software, la interacción con las bases de datos es una tarea cotidiana y, a menudo, compleja. Asegurar que los datos se almacenen, recuperen y manipulen de manera correcta y segura es fundamental para la salud de cualquier aplicación. Aquí es donde entra en juego un concepto crucial: la capa de persistencia.

La capa de persistencia es una abstracción que separa la lógica de negocio de una aplicación de los detalles específicos de cómo los datos son almacenados y recuperados de un medio persistente, típicamente una base de datos. Su objetivo principal es mapear los objetos o estructuras de datos que utiliza la lógica de negocio a la representación que se guarda en la base de datos y viceversa. Es, en esencia, el puente que permite a tus objetos 'vivir' más allá de la ejecución del programa, almacenando su estado para uso futuro.
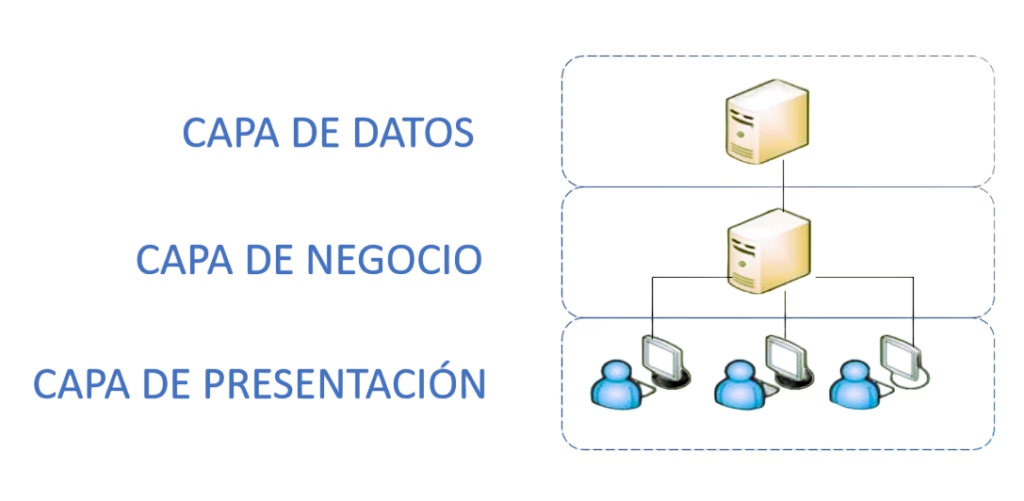
Sin una capa de persistencia bien definida, el código que maneja la lógica de negocio se vería directamente entrelazado con las operaciones de base de datos (como sentencias SQL, conexiones, manejo de transacciones, etc.). Esto lleva a un código más difícil de mantener, probar y modificar, ya que cualquier cambio en el esquema de la base de datos o en la tecnología de persistencia requeriría cambios significativos en múltiples partes de la aplicación.
¿Por qué es Crucial una Capa de Persistencia Dedicada?
Más allá de la simple separación de intereses, una capa de persistencia aborda problemas comunes y a menudo subestimados en el desarrollo de aplicaciones: la validación y la serialización de datos. Estos aspectos, si no se manejan de forma centralizada y cuidadosa, pueden dispersarse por todo el código, dando lugar a inconsistencias y errores difíciles de rastrear.
Considera la validación. Los datos que llegan a tu aplicación (quizás desde un formulario web o una API) deben cumplir ciertas reglas antes de ser almacenados. Por ejemplo, una edad debe estar dentro de un rango razonable, un email debe tener un formato válido, o un campo obligatorio no debe estar vacío. Si esta lógica de validación se repite cada vez que se intenta guardar un dato en diferentes partes del código, es muy probable que se produzcan duplicaciones, omisiones o implementaciones ligeramente diferentes de la misma regla.
De manera similar, la serialización y deserialización implican convertir los objetos complejos de tu aplicación en un formato que la base de datos pueda almacenar (como texto, números, o incluso binario) y luego reconstruirlos al leerlos. Si los detalles de cómo serializar, por ejemplo, una estructura de contacto compleja (con teléfono, email, dirección) a un campo binario en la base de datos se manejan directamente en la lógica de negocio, esa lógica se vuelve innecesariamente complicada y dependiente de los detalles de almacenamiento.
Una capa de persistencia dedicada centraliza estas preocupaciones. Actúa como un punto de control donde los datos son validados según las reglas de la aplicación y transformados (serializados/deserializados) entre el formato de la aplicación y el formato de la base de datos.
Arquitectura de Capas para la Persistencia
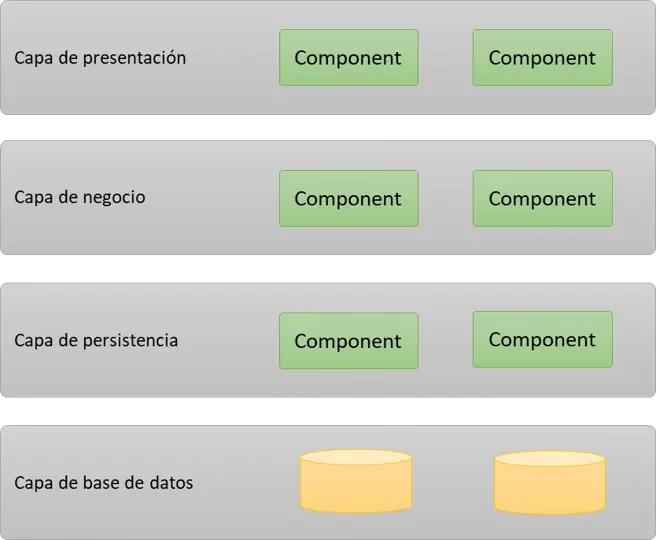
Para abordar estos desafíos de manera efectiva, se puede adoptar una arquitectura de capas bien definida dentro de la propia capa de persistencia. Un enfoque común, como el sugerido en la información proporcionada, podría estructurarse de la siguiente manera:
Capa 1: Plantillas DSL SQL
En la base de la pila, encontramos las definiciones crudas de las operaciones que queremos realizar en la base de datos. Esto a menudo se hace utilizando archivos de plantilla que contienen sentencias SQL (u otro lenguaje de consulta) y metadatos que describen la operación (por ejemplo, si es una lectura, escritura, cuántas filas se esperan, etc.). Herramientas como `sqlc` pueden leer estos archivos. La ventaja aquí es que las consultas están definidas de forma clara y centralizada, separadas del código de la aplicación.
Capa 2: Wrappers de Consultas (Generados Automáticamente)
Por encima de las plantillas SQL, se sitúan los Wrappers de Consultas. Estos son, idealmente, generados automáticamente a partir de las plantillas DSL SQL de la Capa 1. Su función es proporcionar una interfaz de programación fuertemente tipada para ejecutar las consultas definidas. Por ejemplo, si defines una consulta `SELECT * FROM Person WHERE id = ?`, el wrapper generará una función `SelectByID(ctx context.Context, id string) (*Person, error)`.
Estos wrappers manejan los detalles de bajo nivel: abrir conexiones (o usar un pool), ejecutar la sentencia SQL, mapear los resultados crudos de la base de datos a estructuras de datos básicas (que reflejan directamente el esquema de la tabla, como un `struct Person { ID string; FirstName string; ... }`), manejar errores de la base de datos y cerrar recursos. Lo importante es que *no* contienen lógica de validación o serialización específica de la aplicación. Trabajan con los tipos de datos tal como los devuelve o espera la base de datos.
Capa 3: Tipos de Aplicación y Lógica Específica de Persistencia
Esta es una capa crucial que actúa como intermediaria entre los Wrappers de Consultas de bajo nivel y el código de la aplicación. A diferencia de la Capa 2, esta capa no suele ser generada automáticamente. Aquí defines los Tipos de Aplicación, que son las estructuras de datos tal como las entiende y manipula la lógica de negocio (por ejemplo, un objeto `Person` que quizás tenga campos con tipos más complejos o restrinja valores).
Esta capa encapsula la lógica de validación y serialización/deserialización. Antes de llamar a un wrapper de inserción, valida que el objeto de aplicación cumpla con las reglas (como la edad entre 0 y 200). Si la validación falla, el error se propaga antes de siquiera intentar interactuar con la base de datos. También se encarga de serializar los tipos complejos de la aplicación (como un objeto `ContactInfo`) a los formatos que el wrapper de la Capa 2 espera (como un array de bytes). Al leer datos, deserializa los tipos crudos de la base de datos a los tipos de aplicación.
Por ejemplo, una función `InsertPerson(ctx context.Context, person *ApplicationPerson)` en esta capa tomaría un objeto `ApplicationPerson` (que ya ha sido validado o construido de forma que garantiza su validez), serializaría su campo `ContactInfo` a bytes, convertiría la edad a un entero simple, y luego llamaría al wrapper de la Capa 2 `queryWrappers.InsertPerson(ctx, &queryWrappers.InsertPersonParams{...})` pasando los datos en el formato esperado por la base de datos.
Capa 4: Código de la Aplicación
En la cima está el código de negocio real de tu aplicación (por ejemplo, un manejador de peticiones RPC o HTTP). Este código interactúa *únicamente* con la Capa 3. Cuando necesita guardar o recuperar datos de una persona, llama a la función `InsertPerson` o `SelectByID` definida en la Capa 3. Lo maravilloso de este enfoque es que la Capa 4 no necesita preocuparse por:
- Validar los datos de la persona (eso se maneja en la Capa 3 o al construir el tipo de aplicación).
- Serializar o deserializar datos complejos (eso es responsabilidad de la Capa 3).
- Escribir sentencias SQL.
- Manejar los detalles de la conexión a la base de datos o la ejecución de consultas (eso lo hacen los Wrappers de la Capa 2).
El código de la aplicación se vuelve mucho más limpio, enfocado en la lógica de negocio de alto nivel, y significativamente menos propenso a errores relacionados con la persistencia.
Beneficios Clave de una Arquitectura de Capas para la Persistencia
Adoptar este modelo de capas ofrece múltiples ventajas:
- Separación de Intereses Clara: Cada capa tiene una responsabilidad específica, lo que mejora la organización del código.
- Validación Centralizada y Confiable: Las reglas de validación se aplican en un único lugar lógico (Capa 3), garantizando consistencia.
- Manejo Uniforme de Serialización: La serialización y deserialización se gestionan centralmente (Capa 3), evitando código disperso y propenso a errores.
- Correctitud en la Ejecución de Consultas: Los Wrappers de Consultas generados automáticamente (Capa 2) minimizan los errores humanos al ejecutar SQL e interactuar con el driver de la base de datos.
- Facilidad de Mantenimiento y Evolución: Los cambios en la base de datos (esquema) o en la lógica de negocio (validación, serialización) afectan principalmente a una o dos capas, no a toda la base de código.
- Código de Aplicación Más Limpio: La lógica de negocio se libera de las preocupaciones de persistencia, haciéndola más legible y mantenible.
- Mayor Testeabilidad: Cada capa puede ser probada de forma más aislada.
Comparación: Enfoque Monolítico vs. Enfoque por Capas
| Característica | Enfoque Monolítico (Sin Capas) | Enfoque por Capas |
|---|---|---|
| Lógica de Base de Datos | Dispersa en el código de negocio | Centralizada en capas dedicadas |
| Validación | Repetida en múltiples lugares, inconsistente | Centralizada (Capa 3), consistente |
| Serialización/Deserialización | Manejada manualmente en el código de negocio, dispersa | Centralizada (Capa 3), uniforme |
| Ejecución de Consultas | Sentencias SQL escritas y ejecutadas directamente, propensa a errores | Manejada por Wrappers de Consultas (Capa 2), más robusta |
| Acoplamiento | Alto acoplamiento entre negocio y base de datos | Bajo acoplamiento, alta cohesión en cada capa |
| Mantenimiento | Difícil, cambios en DB afectan todo | Más fácil, cambios localizados |
| Testeabilidad | Baja, difícil aislar la lógica de negocio | Alta, capas testeables individualmente |
Preguntas Frecuentes sobre la Capa de Persistencia
¿La capa de persistencia es siempre sinónimo de usar un ORM (Object-Relational Mapper)? No necesariamente. Un ORM es una *herramienta* que ayuda a construir una capa de persistencia al automatizar gran parte del mapeo entre objetos y tablas. Sin embargo, una capa de persistencia se puede implementar manualmente o con otras herramientas (como generadores de código basados en SQL) sin usar un ORM completo.
¿Toda la lógica relacionada con los datos debe ir en la capa de persistencia? La capa de persistencia debe manejar la lógica de *cómo* los datos son almacenados, recuperados, validados en cuanto a su estructura y serializados. La lógica de negocio que *utiliza* esos datos para tomar decisiones o realizar procesos de negocio más complejos reside en capas superiores.
¿Cómo se manejan las transacciones en esta arquitectura? El manejo de transacciones típicamente reside en la Capa 3 o en un servicio de nivel ligeramente superior que orquesta múltiples operaciones de la Capa 3 dentro de una única transacción.
¿Es esta arquitectura adecuada para todo tipo de bases de datos (SQL, NoSQL)? Los principios de separación de intereses, validación y serialización son aplicables a cualquier tipo de almacenamiento persistente, aunque la implementación específica de las capas (especialmente la Capa 1 y 2) variará dependiendo de la tecnología.
En resumen, una capa de persistencia bien diseñada es un componente fundamental para construir aplicaciones robustas, mantenibles y escalables. Al separar claramente las preocupaciones de acceso a datos, validación y serialización de la lógica de negocio, se sienta una base sólida para el desarrollo futuro.
Si quieres conocer otros artículos parecidos a La Capa de Persistencia en Bases de Datos puedes visitar la categoría Bases de datos.
Aprende mas sobre MySQL